
遇见数据集

WithinUsAI/fable_5_distillation_merged_cleaned_25k

收藏
Hugging Face2026-06-18 更新2026-07-22 收录
官方服务:

资源简介:

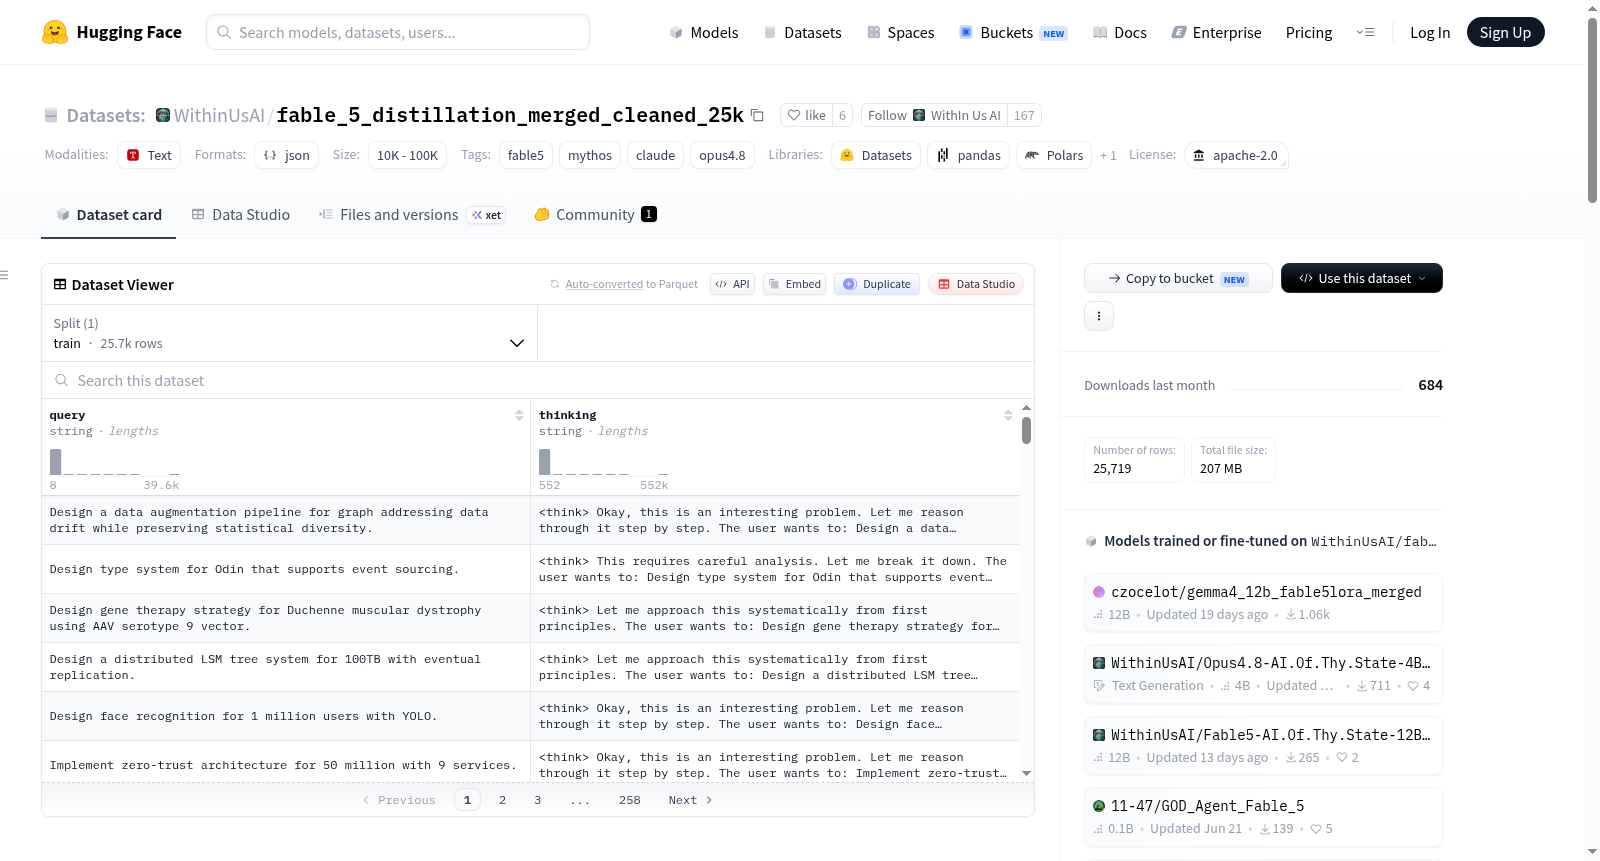
Claude Fable 5蒸馏数据集包含25,719个高质量蒸馏示例,用于训练大型语言模型模仿Claude Fable 5(Anthropic于2026年6月发布的Mythos级模型)的推理风格。该数据集捕捉了Claude Fable 5独特的推理模式,包括系统分解、第一性原理分析、自我验证、替代方案考虑和综合总结。数据集采用JSONL格式,每条记录包含query和thinking字段,其中thinking部分使用`<think>...</think>`标签标注多步思维链。数据覆盖23个以上技术领域,如软件工程、机器学习、系统、科学研究、计算机视觉、金融等。每个示例均包含具体的参数值,无重复或虚假内容,思维轨迹完整连贯。平均每个思维轨迹长度为6,220字符,最小552字符,最大552,213字符。数据集适用于监督微调,以提升链式思维推理能力。

Claude Fable 5 Distillation Dataset contains 25,719 high-quality distilled examples for training LLMs to mimic Claude Fable 5s reasoning style — featuring multi-step chain-of-thought with `<think>` tags across 23+ technical domains. This dataset captures the distinctive reasoning patterns of Claude Fable 5 (Anthropics Mythos-class model released June 2026): systematic decomposition, first-principles analysis, self-verification, alternative consideration, and synthesis. The dataset is in JSONL format with `{"query": "...", "thinking": "<think>...</think>"}` structure. It covers domains such as Software Engineering, Machine Learning, Systems, Scientific Research, Computer Vision, Finance, etc. All examples have concrete parameter values, no duplicates, and complete reasoning traces. The average thinking length is 6,220 characters, with min 552 and max 552,213 characters. It is designed for supervised fine-tuning to improve chain-of-thought reasoning.
提供机构:
WithinUsAI
搜集汇总
数据集介绍
WithinUsAI/fable_5_distillation_merged_cleaned_25k 数据集图片
构建方式
本数据集源自对Anthropic公司于2026年6月发布的Mythos级模型Claude Fable 5的推理风格进行蒸馏,通过融合四个不同的数据源,经过去重、清洗与格式统一化处理,最终构建出包含25,719个高质量示例的数据集。每条记录以JSONL格式存储,涵盖'query'与'thinking'两个字段,其中thinking字段完整保留了模型特有的多步链式推理过程,并以<think>标签进行标识,确保推理路径的透明性与可复现性。
使用方法
本数据集适用于大型语言模型的监督微调,以增强其链式推理能力。推荐的训练策略是先使用全部25,719个示例进行广泛的推理能力覆盖,随后可根据查询关键词筛选特定领域子集进行针对性训练。在微调过程中需确保分词器正确保留<think>标记,建议学习率设置在1e-5至2e-5之间,以保证蒸馏效果的稳定性与模型的泛化性能。
背景与挑战
背景概述
该数据集名为fable_5_distillation_merged_cleaned_25k,由Anthropic于2026年6月在其Mythos级模型Claude Fable 5发布后创建,旨在捕捉该模型独特的推理风格,包括系统分解、第一性原理分析、自我验证、替代方案考量与综合归纳。数据集包含25,719条高质量蒸馏样本,覆盖软件工程、机器学习、科学计算、金融等23个以上技术领域,每条样本均以JSONL格式存储,包含用户查询与带有<think>标签的多步思维链推理过程。数据集通过合并四个来源并实施MD5去重,确保了每条样本的完整性与一致性,平均推理长度达6,220字符,为训练大型语言模型模仿Claude Fable 5的推理模式提供了标准化、多样化的训练基础。
当前挑战
该数据集所解决的领域问题在于如何高效训练大型语言模型掌握复杂多步推理能力,传统监督微调方法缺乏对结构化、自验证型思维链的建模,常导致模型在长链条逻辑任务中产生局部跳跃或错误累积。在构建过程中,面临的关键挑战包括:1)从多源异构数据中提取并统一为{query, thinking}格式,需确保推理轨迹无虚假或死胡同;2)在23个以上技术领域间保持思维风格的动态一致性,避免模型过拟合至单一域;3)处理最长552,213字符的推理轨迹时,需保证tokenization与注意力机制对<think>标签的敏感度;4)通过去重与参数验证剔除占位样本,同时维持可扩展监督微调的有效学习率区间。
常用场景
经典使用场景
该数据集最经典的使用场景在于对大型语言模型进行监督微调,以增强其链式思维推理能力。通过提供25,719条高质量、多步骤的推理轨迹,研究者可利用此数据集让模型学习从问题分解、第一性原理分析到自我验证与综合归纳的完整推理范式。这些数据覆盖软件工程、机器学习、计算机视觉等23个技术领域,每条样本均包含以<think>标签包裹的详尽思考过程,使得训练后的模型能够在面对复杂任务时复现类人式的系统性推演。
解决学术问题
该数据集有效解决了当前学术界在推理增强型语言模型训练中的数据稀缺问题。传统监督微调数据集往往偏重最终答案而忽略中间推理过程,导致模型在复杂多步推理时表现欠佳。Fable 5蒸馏数据集通过提供结构化的思维链轨迹,使得研究者能够探索如何将顶尖推理模型的认知策略迁移至较小规模的模型。这一资源推动了可解释性与推理透明度的研究,使模型不仅能够给出答案,更能展示其推导逻辑,从而提升模型在数学、物理、编程等需要严格推理的学术场景中的表现。
实际应用
在实际应用中,该数据集可赋能开发者构建具有深度推理能力的专业智能助手。例如在软件工程领域,经过微调的模型能够对复杂系统架构进行逐步分析,识别性能瓶颈并提出优化方案;在金融风控场景中,模型可结合多步推理来评估交易策略的潜在风险。此外,该数据集支持领域特定子集的提取,使企业能够针对性地优化模型在生物信息学、物联网或量子计算等垂直领域的推理质量,从而将高级推理能力落地至生产环境中的决策支持系统。
数据集最近研究
最新研究方向
在大型语言模型推理能力蒸馏的前沿领域,Fable 5蒸馏数据集聚焦于捕捉并迁移Anthropic神话级模型Claude Fable 5那标志性的多步思维链推理风格。该数据集囊括超过2.5万个高质量范例,覆盖软件工程、机器学习、生物信息学、量子计算等23个技术领域,每个样本均嵌入<think>标签封装的深度推理轨迹。这一方向回应了2026年业界对模型透明性与可解释性变革的迫切需求——通过系统化蒸馏第一性原理分析、自我验证与综合归纳等认知策略,使普通语言模型能够习得顶级推理框架的思辨精髓。该数据集的出现,为强化学习与监督微调之外开辟了第三条路径:以推理风格迁移催化通用人工智能在复杂任务中的决策稳健性,对推动安全可控的AI系统发展具有里程碑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

