
遇见数据集

WithinUsAI/The_Research_From_WithIn_10k

收藏
Hugging Face2026-06-07 更新2026-06-14 收录
官方服务:

资源简介:

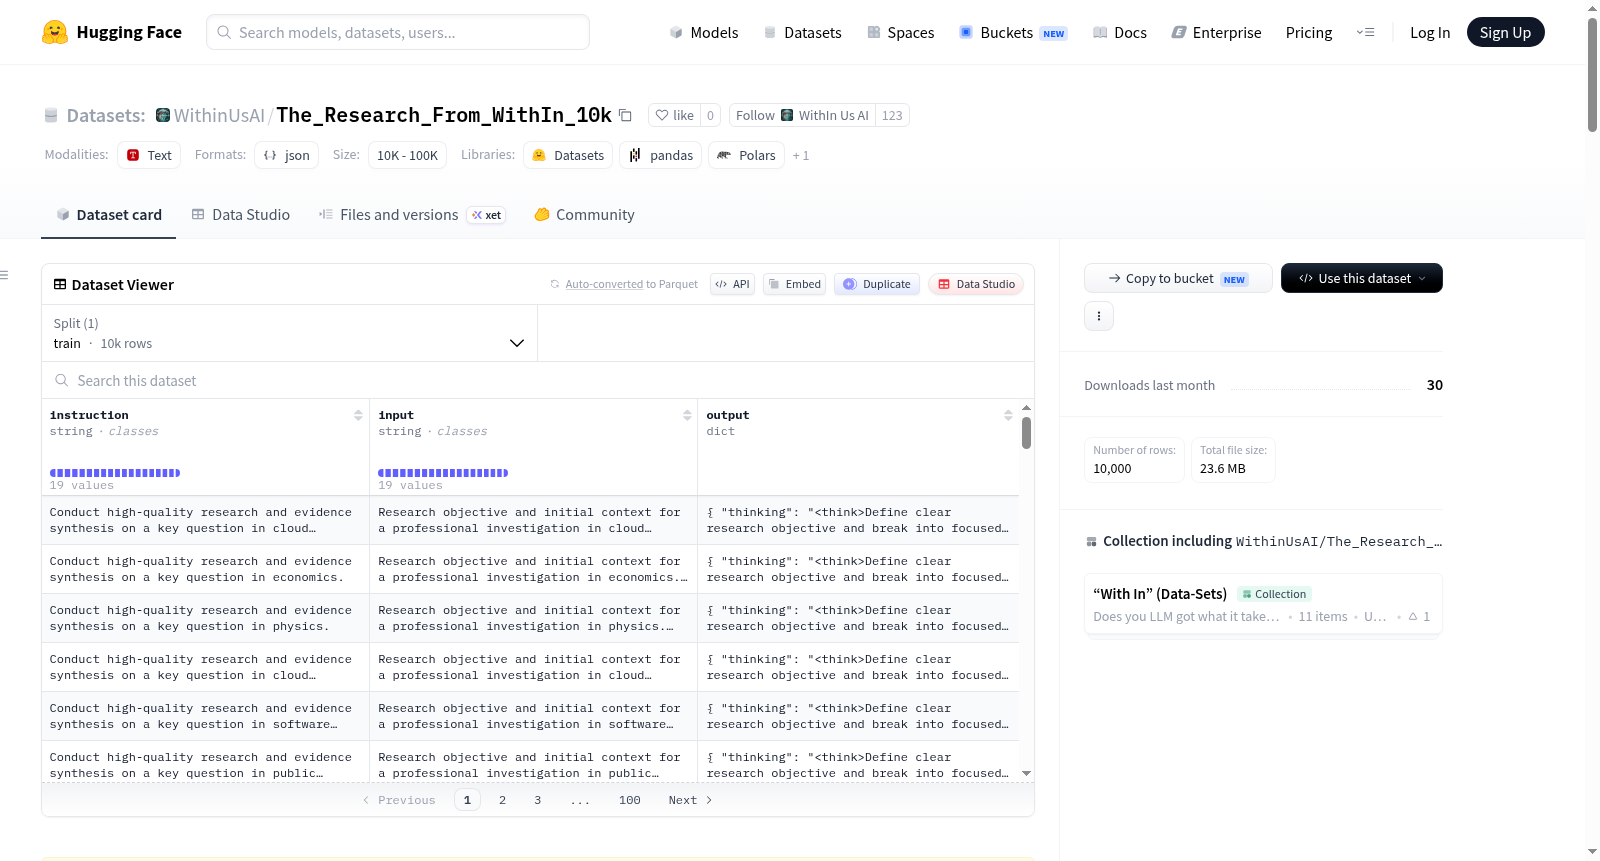
The_Research_From_WithIn_10k 是一个前沿质量的数据集,旨在训练高级自主代理语言模型掌握高质量的研究方法、信息收集、来源评估、证据合成、知识整合、批判性分析和专业报告。每个示例都提供一个真实的专业研究任务,包括明确的目标、聚焦的研究问题、从多个来源收集的证据、来源评估、综合发现、识别的知识差距和基于证据的结论。思考轨迹展示了专业调查、证据收集、合成、规划、优先级排序、评估、验证和决策制定。数据集包含10,000个独特示例,覆盖AI研究、机器学习、软件工程、云计算、网络安全防御、医学、生物学、化学、物理学、经济学、金融、初创企业、业务运营、基础设施、公共政策、教育、制造业、物流、机器人技术和科学发现等多个领域。数据格式为JSONL,每个JSON对象包含指令、输入和输出字段,输出字段进一步细分为思考、研究目标、研究问题、收集的证据、来源评估、综合发现、知识差距和结论。数据集经过严格的去重和验证过程,确保逻辑一致性和专业质量,适用于监督微调代理模型进行研究和证据合成任务。

The_Research_From_WithIn_10k is a cutting-edge high-quality dataset designed to train advanced autonomous agent large language models to master high-quality research methodologies, information gathering, source evaluation, evidence synthesis, knowledge integration, critical analysis, and professional report writing. Each sample provides a real-world professional research task, including clear objectives, focused research questions, evidence collected from multiple sources, source evaluation, synthesized findings, identified knowledge gaps, and evidence-based conclusions. Thought trajectories demonstrate professional investigation, evidence collection, synthesis, planning, prioritization, evaluation, validation, and decision-making. The dataset contains 10,000 unique samples covering multiple domains including AI research, machine learning, software engineering, cloud computing, cybersecurity defense, medicine, biology, chemistry, physics, economics, finance, startups, business operations, infrastructure, public policy, education, manufacturing, logistics, robotics, and scientific discovery. The data format is JSONL, with each JSON object containing fields for "instruction", "input", and "output"; the "output" field is further subdivided into "thought", "research objective", "research question", "collected evidence", "source evaluation", "synthesized findings", "knowledge gaps", and "conclusion". The dataset has undergone strict deduplication and validation processes to ensure logical consistency and professional quality, making it suitable for supervised fine-tuning of agent models for research and evidence synthesis tasks.
提供机构:
WithinUsAI
搜集汇总
数据集介绍
WithinUsAI/The_Research_From_WithIn_10k 数据集图片
构建方式
The_Research_From_WithIn_10k由WithIn Us Ai精心构建,汇聚了10,000个独一无二的专业研究范例。每个范例均模拟真实场景,包含清晰的研究目标、聚焦的研究问题、多源证据收集、严格的来源可信度评估、证据综合、知识缺口识别及基于证据的结论。数据集采用JSONL格式,每条记录都内置了详尽的思维轨迹,展现从问题提出、证据搜集、优先级排序、评估验证到最终决策的完整专业推理过程。构建过程中实施了激进的语义与结构去重,确保每一条目在目标、问题与综合框架上的唯一性,并经过逻辑一致性与专业性的严格验证。
使用方法
该数据集主要用于对大型语言模型进行监督式微调,以增强其在专业研究调查与证据综合任务上的表现。建议在训练过程中保留完整的<think>思维链标记,以支持链式推理训练。训练时可将该数据集与规划、决策、工作流、验证、记忆及自主性等数据集搭配使用,构建从研究到行动的完整自主式智能体能力。数据集采用MIT开源许可,允许免费用于研究与商业用途,仅需在引用时标注出处,推荐引用格式为BibTeX条目。
背景与挑战
背景概述
在大型语言模型日益向自主化、多步骤推理能力演进的时代背景下,构建面向复杂研究任务的高质量训练数据成为提升模型核心智能水平的关键。由WithIn Us Ai于2026年创建的The_Research_From_WithIn_10k数据集,旨在训练前沿的自主代理语言模型掌握专业研究方法论。该数据集包含10,000个独特的专业研究范例,覆盖人工智能、医学、金融、公共政策等二十余个领域,每个范例均包含完整的思考轨迹、研究目标、证据搜集、来源评估、综合发现、知识缺口识别及基于证据的结论。其核心研究问题聚焦于如何让模型自主完成从问题提出到专业报告撰写的全流程研究任务,在推动自主代理系统具备严谨、透明的学术级研究能力方面具有重要影响力。
当前挑战
该数据集所面临的领域挑战主要源自自主研究任务的复杂性:模型需在信息不确定、来源多样且可能存在偏见的环境中,精准评估证据质量并做出可靠推理,同时需平衡计算效率与解释性要求,以满足金融、医疗等监管领域对可审计性的严苛标准。在构建过程中,挑战尤为突出:首先,需保证每个范例在逻辑上高度一致且具备真实的专业水准,避免模板化内容;其次,需对10,000个示例进行激进的语义与结构去重,确保无重复或近似条目;最后,还需对每个条目的思考轨迹、证据评估与结论之间的因果链进行严格验证,从而在规模化生产中维持前沿质量与训练信号的纯净性。
常用场景
经典使用场景
在大型语言模型(LLMs)向自主智能体演进的前沿探索中,高质量研究能力成为评估模型认知水平的试金石。该数据集的核心应用场景在于为研究者提供万余条涵盖多元学科的专业研究轨迹,用于训练模型掌握从研究目标拆解、信息检索、信源可信度评估到证据综合与知识整合的完整研究范式。每条样本结构化的思维链深度展现了系统性调研、证据优先级排序及不确定性权衡的过程,尤其适用于监督式微调与思维链推理训练,使语言模型在复杂研究任务中展现出接近资深研究者的专业素养。
解决学术问题
当前自主智能体研究面临的核心瓶颈在于模型普遍缺乏严谨的证据推理能力和科学方法论素养,往往产生似是而非的结论或忽略关键信息缺口。该数据集系统性地回应了这一挑战,通过标准化研究框架帮助模型习得如何从多源证据中提炼洞见、识别知识盲区,并在结论中恰当表达置信度与限制条件。其深远意义在于推动语言模型从简单的模式匹配转向基于证据的批判性思维,为构建真正具备独立研究能力的学术助手提供了不可或缺的训练基础。
实际应用
在人工智能产业化浪潮中,该数据集所塑造的研究能力正催生一系列具有实际价值的应用形态。金融机构可借助基于此数据集训练的研究智能体完成信贷风险模型的系统性文献综述与可行性评估;医疗健康领域则能运用其自动化证据综合能力辅助临床决策支持系统的知识更新。更广泛地,该技术可应用于法律案件的前期证据梳理、科技情报的竞争分析、政策制定的多源证据整合等专业场景,显著提升知识工作者的研究效率与结论可靠性。
数据集最近研究
最新研究方向
该数据集聚焦于构建面向自主智能体的前沿研究方法论与证据综合能力,旨在通过10,000个高质量的专业研究实例,训练大型语言模型掌握信息搜集、来源评估、证据综合、批判性分析及专业报告撰写等核心技能。结合当前大语言模型向自主智能体演进的趋势,该数据集弥补了现有模型在复杂研究任务中缺乏系统方法论与严谨推理链条的短板,体现了从单纯语言生成向具备专业研究能力的自主系统转变的前沿方向。其MIT开源许可和涵盖多领域的设计,为开发能独立进行高质量研究、筛选信息并产出证据驱动结论的智能体提供了关键训练资源,对推动人工智能在科研、金融、医疗等领域的深度应用具有重要价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

