saipuneethgottam/pickplace_235cam_newdemos_20260526_161032_remapped
收藏资源简介:
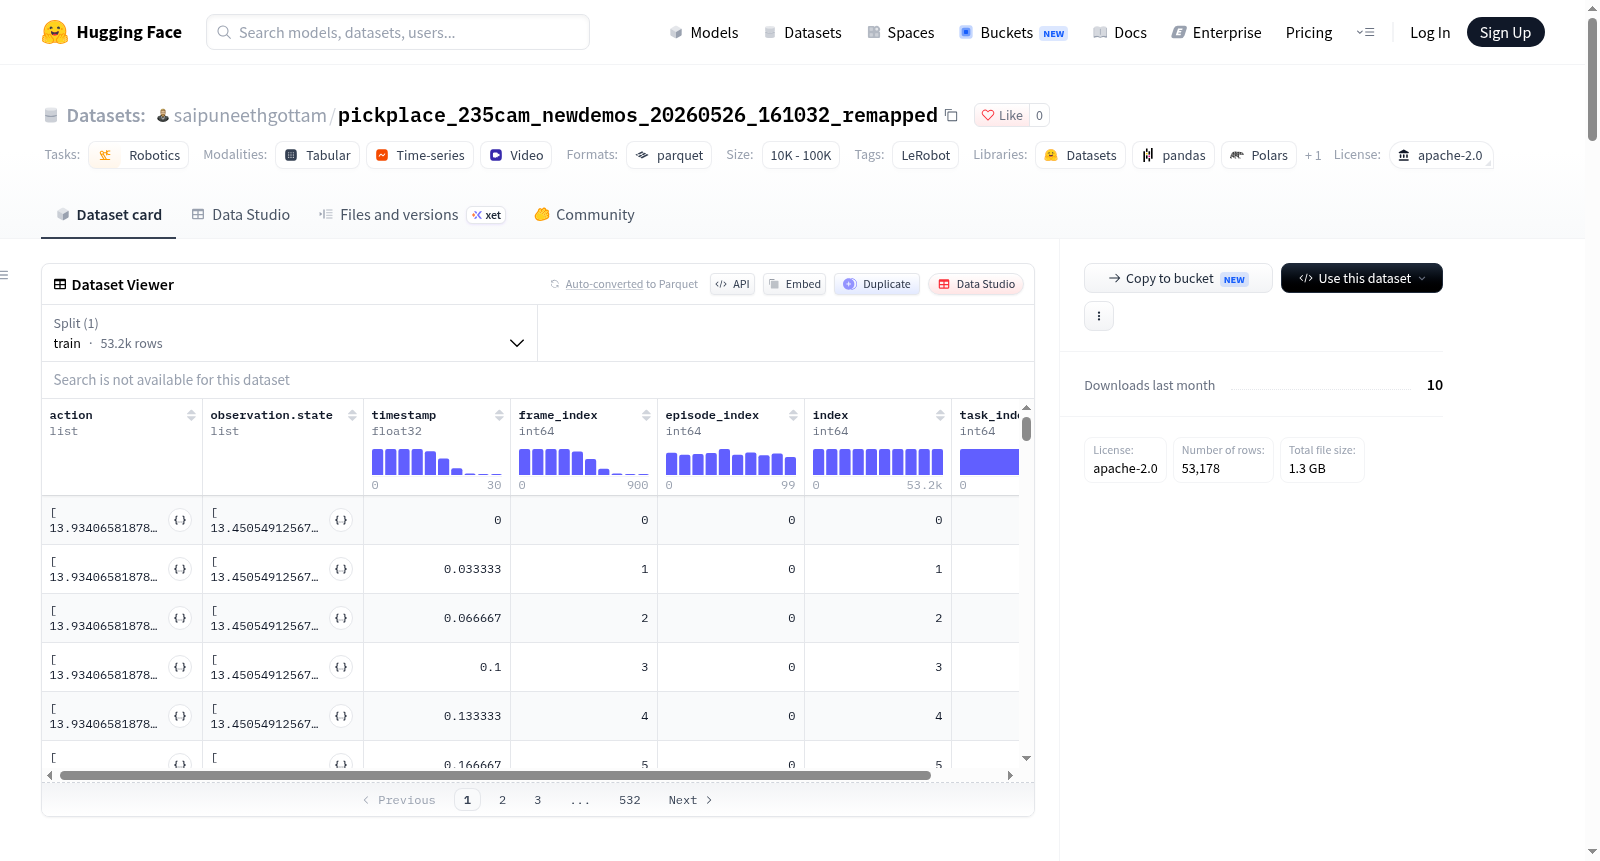
这是一个机器人操作数据集,专注于拾取放置任务。数据集使用LeRobot创建,包含100个训练集episodes,总帧数53178。数据特征包括:三个摄像头的视频观察(camera1和camera2分辨率为720x1280,camera3为480x640,均以30fps的AV1编码视频格式存储)、机器人状态(如肩部平移、肩部升降、肘部弯曲、腕部弯曲、腕部旋转和夹爪位置等6个关节的位置数据)和动作数据(同样为6个关节位置)。数据集以Parquet文件格式组织,机器人类型为“so_follower”,适用于机器人学习和控制任务。
--- 许可证:Apache-2.0 任务类别: - 机器人学 标签: - LeRobot 配置项: - 配置名称:默认 数据文件路径:data/*/*.parquet --- 本数据集由LeRobot构建,其官方仓库地址为:https://github.com/huggingface/lerobot。 可点击下方链接可视化本数据集: https://huggingface.co/spaces/lerobot/visualize_dataset?path=saipuneethgottam/pickplace_235cam_newdemos_20260526_161032_remapped (附带明暗模式适配的可视化徽章) ## 数据集说明 - **主页:** [需补充更多信息] - **论文:** [需补充更多信息] - **许可证:** Apache-2.0 ## 数据集结构 `meta/info.json` 文件包含以下元数据: json { "分块大小": 1000, "代码库版本": "v3.0", "数据文件总大小(MB)": 100, "数据文件路径模板": "data/chunk-{chunk_index:03d}/file-{file_index:03d}.parquet", "数据特征": { "动作(action)": { "数据类型": "float32", "字段名称": [ "肩关节旋移位置", "肩关节抬升位置", "肘关节屈曲位置", "腕关节屈曲位置", "腕关节旋转位置", "夹爪位置" ], "形状": [6] }, "回合索引(episode_index)": { "数据类型": "int64", "字段名称": null, "形状": [1] }, "帧索引(frame_index)": { "数据类型": "int64", "字段名称": null, "形状": [1] }, "全局索引(index)": { "数据类型": "int64", "字段名称": null, "形状": [1] }, "观测-图像-相机1(observation.images.camera1)": { "数据类型": "视频(video)", "详细信息": { "是否含音频": false, "视频通道数": 3, "视频编码格式": "av1", "恒定速率因子(CRF)": 30, "额外编码选项": {}, "快速解码开关": 0, "帧率": 30, "关键帧间隔": 2, "视频高度": 720, "是否为深度图": false, "像素格式": "yuv420p", "编码预设等级": 12, "视频处理后端": "pyav", "视频宽度": 1280 }, "维度名称": [ "高度", "宽度", "通道数" ], "形状": [720, 1280, 3] }, "观测-图像-相机2(observation.images.camera2)": { "数据类型": "视频(video)", "详细信息": { "是否含音频": false, "视频通道数": 3, "视频编码格式": "av1", "恒定速率因子(CRF)": 30, "额外编码选项": {}, "快速解码开关": 0, "帧率": 30, "关键帧间隔": 2, "视频高度": 720, "是否为深度图": false, "像素格式": "yuv420p", "编码预设等级": 12, "视频处理后端": "pyav", "视频宽度": 1280 }, "维度名称": [ "高度", "宽度", "通道数" ], "形状": [720, 1280, 3] }, "观测-图像-相机3(observation.images.camera3)": { "数据类型": "视频(video)", "详细信息": { "是否含音频": false, "视频通道数": 3, "视频编码格式": "av1", "恒定速率因子(CRF)": 30, "额外编码选项": {}, "快速解码开关": 0, "帧率": 30, "关键帧间隔": 2, "视频高度": 480, "是否为深度图": false, "像素格式": "yuv420p", "编码预设等级": 12, "视频处理后端": "pyav", "视频宽度": 640 }, "维度名称": [ "高度", "宽度", "通道数" ], "形状": [480, 640, 3] }, "观测-状态(observation.state)": { "数据类型": "float32", "字段名称": [ "肩关节旋移位置", "肩关节抬升位置", "肘关节屈曲位置", "腕关节屈曲位置", "腕关节旋转位置", "夹爪位置" ], "形状": [6] }, "任务索引(task_index)": { "数据类型": "int64", "字段名称": null, "形状": [1] }, "时间戳(timestamp)": { "数据类型": "float32", "字段名称": null, "形状": [1] } }, "全局帧率": 30, "机器人类型": "so_follower", "数据集拆分": { "训练集": "0:100" }, "总回合数": 100, "总帧数": 53178, "总任务数": 1, "视频文件总大小(MB)": 200, "视频文件路径模板": "videos/{video_key}/chunk-{chunk_index:03d}/file-{file_index:03d}.mp4" } ## 引用说明 **BibTeX格式引用:** bibtex [需补充更多信息]