
遇见数据集

Realmbird/nla-thought-anchors-answer-step2

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

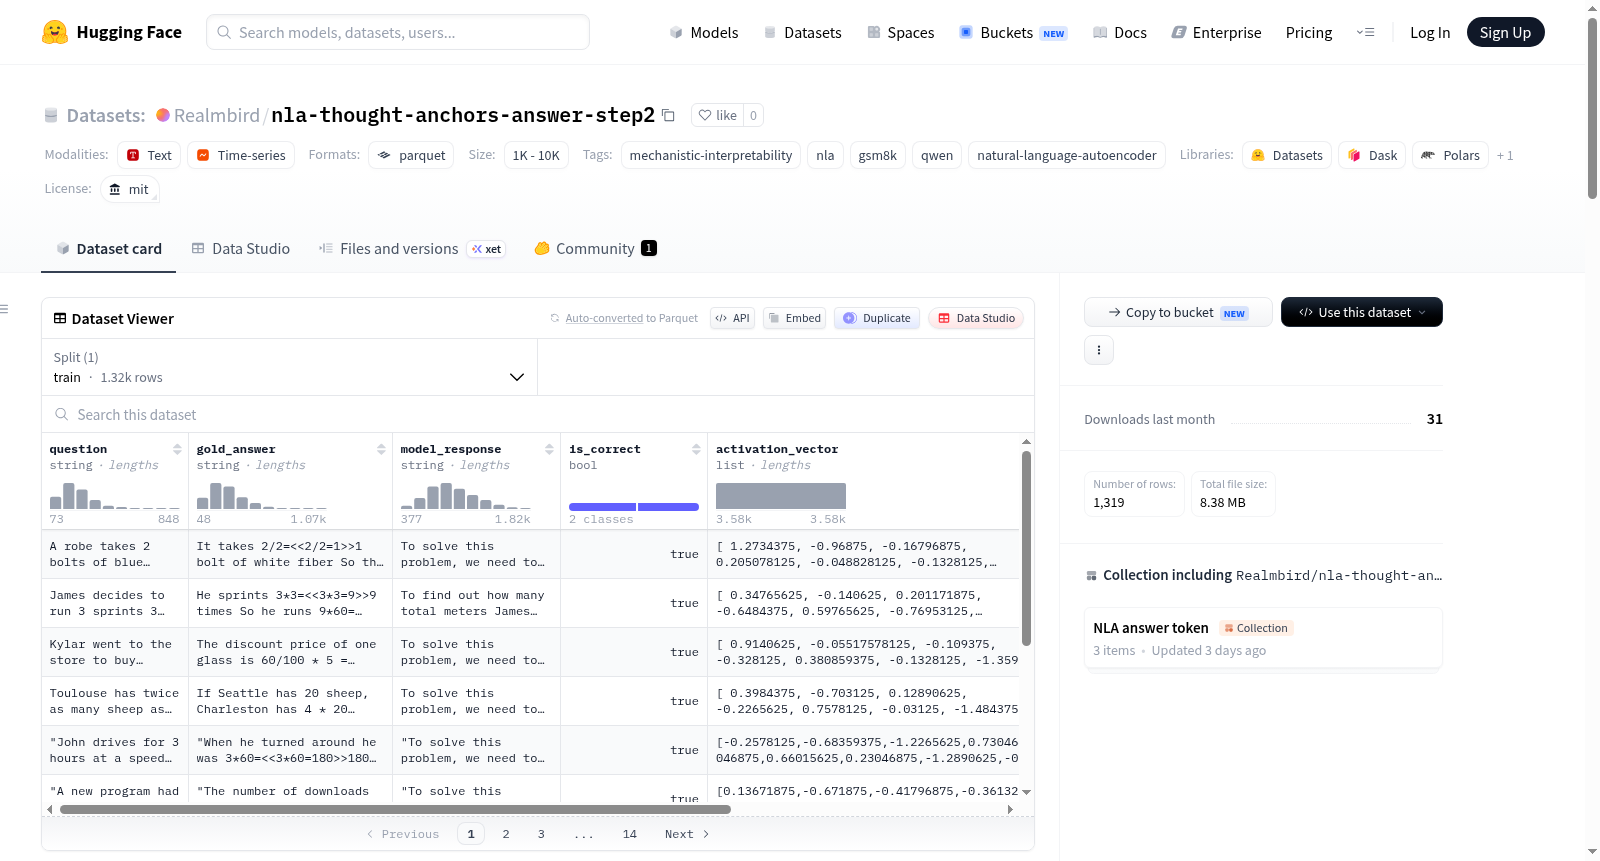
该数据集名为nla-thought-anchors-answer-step2,是NLA(自然语言自编码器)思想锚点管道的第一步。它基于GSM8K测试集,从Qwen2.5-7B-Instruct模型的第20层残差流激活中提取,提取位置在答案数字令牌处(即第一个数字写入后)。数据集包含GSM8K数学问题、模型的完整思维链响应、激活向量以及NLA演员生成的激活自然语言描述,用于机制可解释性研究。数据分为正确和错误示例,总共有1319个样本。研究发现,在正确示例中,NLA描述包含数字答案字面字符串的比率为18.0%,略高于在####令牌处提取的变体。

This dataset is named nla-thought-anchors-answer-step2, and it constitutes the first step of the NLA (Natural Language Autoencoder) thought anchor pipeline. It is based on the GSM8K test set, extracted from the residual stream activations of the 20th layer of the Qwen2.5-7B-Instruct model, at the position of the answer's numeric token (i.e., immediately after the first digit is written). The dataset includes GSM8K math problems, the model's full chain-of-thought responses, activation vectors, and natural language descriptions of activations generated by the NLA actor, for mechanistic interpretability research. The data is split into correct and incorrect examples, with a total of 1319 samples. Studies have found that among the correct examples, the proportion of NLA descriptions containing the literal string of the numerical answer is 18.0%, which is slightly higher than the variant extracted at the #### token position.
提供机构:
Realmbird
搜集汇总
数据集介绍
Realmbird/nla-thought-anchors-answer-step2 数据集图片
构建方式
该数据集基于GSM8K测试集构建,聚焦于Qwen2.5-7B-Instruct模型在解码最终答案首个数字标记时的内部表征。通过提取模型第20层残差流的激活向量,并借助自然语言自动编码器(NLA)actor将其转化为可读的自然语言描述,形成从数学问题到模型内部状态再到语言解释的完整映射。数据集中的激活值在模型生成序列中“####”标记后的首个答案数字处抽取,此时答案已写入上下文,使得该位置的编码最具代表性。
使用方法
用户可通过HuggingFace Datasets库便捷加载该数据,代码示例:`from datasets import load_dataset; ds = load_dataset('Realmbird/nla-thought-anchors-answer-step2')`。加载后可按correct或incorrect子集遍历,获取每条样本中的问题文本、模型完整推理过程、激活向量及NLA描述等字段。该数据集适用于分析语言模型如何编码数学推理中的数值信息,支持与hash-token变体或原始激活数据集的对比研究,亦可用于训练或评估NLA组件的性能。
背景与挑战
背景概述
该数据集由Realmbird团队于近期创建,聚焦于机械可解释性(mechanistic interpretability)领域,旨在通过自然语言自编码器(Natural Language Autoencoder, NLA)技术,揭示大语言模型在数学推理任务中的内部表征机理。基于Qwen2.5-7B-Instruct模型在GSM8K测试集上的第20层残差流激活值,数据集在模型输出最终答案数字(answer digit token)处进行提取,并利用NLA生成对应的自然语言描述。其核心研究问题在于探明模型如何编码数学推理中的关键信息,尤其是答案数字在模型内部表示中的具象化方式。该数据集作为`nla-thought-anchors`流水线的第二环节,为理解大模型在符号推理任务中的中间状态提供了独特的视角,对推动神经网络透明化研究具有重要价值。
当前挑战
当前数据集面临多重挑战。一方面,在领域问题层面,模型对答案信息的编码存在明显的稀疏性——仅约18%的正确样本和7.3%的错误样本的NLA描述中包含实际答案数字,这与理想的可解释性目标相距甚远,反映出大模型内部表征与人类可理解语义之间仍然存在巨大鸿沟。另一方面,构建过程中的挑战同样显著:NLA策略器(actor)训练于竞赛数学文本,却在GSM8K口语化应用题上进行推理,这种分布外迁移导致描述质量受限;同时,在`####`标记处提取激活时,答案尚未被完全写入上下文,使得信息编码更为模糊,而选择答案数字符位置虽有所提升,仍远低于Ryan Greenblatt在Gemma模型上达到的约80%的包含率,凸显出模型架构、数据集特质与可解释性方法之间复杂的交互效应。
常用场景
经典使用场景
在可解释性机制研究领域,nla-thought-anchors-answer-step2数据集被广泛应用于语言模型内部计算过程的探析。该数据集记录了大语言模型Qwen2.5-7B-Instruct在解答GSM8K数学推理问题时,其第20层残差流在答案数字标记处的激活状态,并通过自然语言自编码器(NLA)将这些高维激活转化为语义描述。研究者常利用这一数据来剖析模型如何在链式推理的最终阶段编码与输出具体数学答案,从而揭示数值信息在深层网络中的表示方式。数据集特别提供了回答正确与错误两种不同情境,为对比分析模型在不同推理质量下的内部表征差异提供了宝贵素材。
解决学术问题
该数据集系统性地回应了机械可解释性中关于语言模型内部数值表征如何映射为具体符号输出的核心问题。传统的分析方法往往依赖间接探针或启发式规则,难以直接获取神经元激活的语义内容。通过引入NLA框架对残差流激活进行自然语言表达,该数据集为研究模型在推理链末尾如何聚焦于最终答案并完成符号写入提供了直观窗口。数据表明,在答案标记处约有18%的激活描述直接包含数值信息,这一发现证实了深层网络中存在特定的数值编码机制,为理解语言模型实现算术推理的神经基础提供了关键经验证据。
实际应用
在实际应用中,该数据集支撑了语言模型推理透明度与可信度的提升研究。开发者和安全研究人员可以借助数据集的激活描述,构建模型行为监控系统,实时检测模型在数学推理任务中是否采用了合理的内在计算路径。例如,在人工智能辅助教育场景中,通过比对模型内部对答案的编码描述与标准解法,能够自动识别可能存在的逻辑偏差或计算错误。此外,该数据集为低资源环境下的推理优化提供了参考基准,帮助工程师通过调整特定层的激活模式来提升模型在数学问题上的准确性。
数据集最近研究
最新研究方向
该数据集聚焦于机械可解释性(mechanistic interpretability)前沿,通过自然语言自编码器(NLA)将大语言模型Qwen2.5-7B-Instruct在GSM8K数学推理任务中第20层残差流的激活向量转化为可读的自然语言描述。研究热点在于探索模型内部对数学答案的编码机制:在模型输出最终答案的数字标记(answer digit token)处提取激活,并发现约18%的正确样例描述直接包含数值答案,虽低于Gemma模型的80%,但揭示了NLA跨域泛化的挑战——即训练于竞赛数学的NLA角色应用于GSM8K词问题时存在分布偏移。这项工作将激活值与语义描述对齐,为理解语言模型如何进行符号推理与数值表征提供了关键工具,推动了可解释AI从黑盒分析向语义化、可验证方向演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

