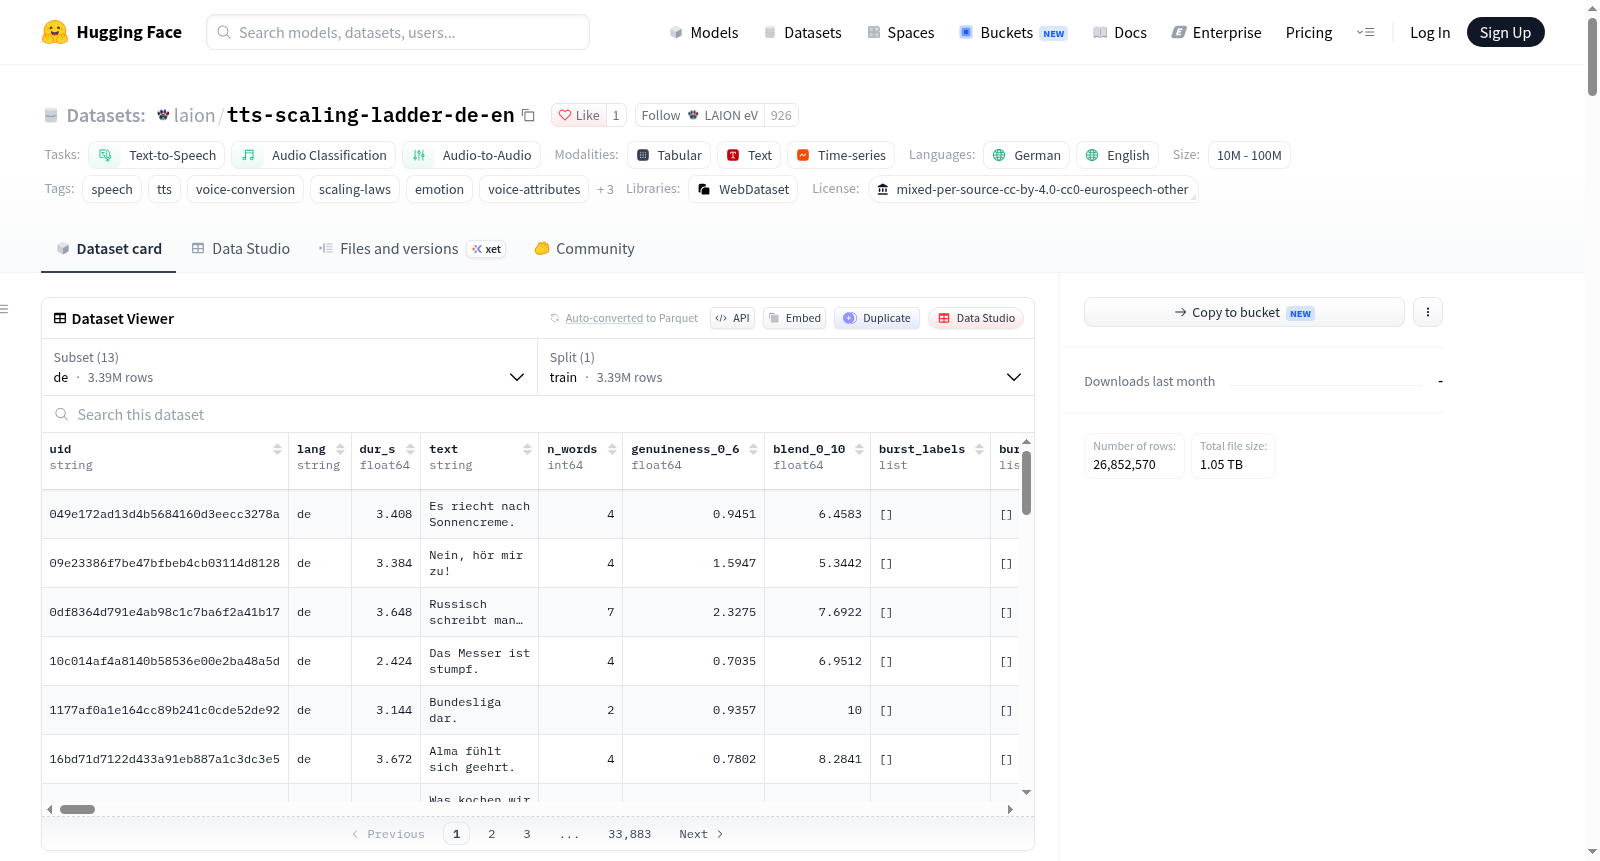
tts-scaling-ladder-de-en
收藏资源简介:
TTS Scaling Ladder DE/EN 是一个为缩放定律实验设计的多层级、平衡、开放许可的语音数据集。它包含八个严格嵌套的层级(tier0 至 tier7)和一个独立的 held-out 评估集。每个层级在语言(德语/英语各 50%)和来源(真实录音/合成语音各 50%)上完全平衡,并在 40 个 EmoNet 情感类别和 57 个 VoiceNet 声音维度上均匀分层。总数据量从 tier0 的 100 小时扩展到 tier7 的 20,000 小时,held-out 集有 80 小时。每个样本包含 MP3 音频、音频令牌代码和 JSON 记录。该数据集适用于文本到语音(TTS)模型训练、语音转换、音频基础模型预训练、情感和声音属性分析以及缩放定律研究。
TTS Scaling Ladder DE/EN is a multi-tier, balanced, openly licensed speech dataset designed for scaling law experiments. It comprises eight strictly nested tiers (tier0 to tier7) and a separate held-out evaluation set. Each tier is perfectly balanced by language (50% German, 50% English) and source (50% real recordings, 50% synthetic speech), and evenly stratified across 40 EmoNet emotion categories and 57 VoiceNet voice dimensions. Data volume ranges from 100 hours in tier0 to 20,000 hours in tier7, with an 80-hour held-out set. Each sample includes MP3 audio, audio token codes, and a JSON record. The dataset is suitable for text-to-speech (TTS) model training, voice conversion, audio foundation model pretraining, emotion and voice attribute analysis, and scaling law research.
TTS Scaling Ladder DE/EN 数据集总结
一、数据集概述
TTS Scaling Ladder DE/EN 是一个用于 TTS(文本转语音)、语音转换及音频基础模型缩放律(scaling-law)实验的嵌套式八层语音数据集。所有层级均为严格嵌套关系(Tier N ⊂ Tier N+1),每层满足以下平衡特性:
- 语言:50/50 德语/英语
- 来源:每种语言内部 50/50 真实/合成
- 分层:在上述四个单元格内,分别按 40 个 EmoNet 情绪类别均匀分布(流程 A)和 57 个 VoiceNet 声音维度 × 10 分位数均匀分布(流程 B)
- 选择性:最小层级最具选择性,包含最极端的情绪和最高质量样本
二、数据集基本信息
| 项目 | 内容 |
|---|---|
| 许可证 | 混合许可证(CC-BY-4.0 / CC-0 / EuroSpeech / other,按来源区分) |
| 语言 | 德语(de)、英语(en) |
| 任务类别 | text-to-speech、audio-classification、audio-to-audio |
| 标签 | speech、tts、voice-conversion、scaling-laws、emotion、voice-attributes、vocal-bursts、moss、webdataset |
| 规模 | 1M < n < 10M |
| 数据集地址 | https://huggingface.co/datasets/laion/tts-scaling-ladder-de-en |
三、层级结构
| tier | 每语言小时数(DE / EN) | 总计 | 用途 | 本版本元素数 | 本版本小时数 |
|---|---|---|---|---|---|
| 0 | 50 / 50 | 100 | 微核心、基线、超参数搜索 | 41,771 | 100.0 |
| 1 | 125 / 125 | 250 | 小型收敛测试 | 100,858 | 249.9 |
| 2 | 250 / 250 | 500 | 声学特征饱和 | 197,662 | 500.1 |
| 3 | 500 / 500 | 1,000 | 计算最优锚点(1×) | 382,768 | 1,000.0 |
| 4 | 1,250 / 1,250 | 2,500 | 2.5× | 912,789 | 2,500.1 |
| 5 | 2,500 / 2,500 | 5,000 | 5× | 1,764,990 | 5,000.4 |
| 6 | 5,000 / 5,000 | 10,000 | 10× | 3,425,099 | 10,000.7 |
| 7 | 10,000 / 10,000 | 20,000 | 全语料基准,20× | 6,666,998 | 20,001.5 |
| held-out | 40 / 40 | 80 | 评估集,与所有层级不相交,同分层 | 25,639 | 80.1 |
- 嵌套关系:Tier N ⊂ Tier N+1 为构造性保证。整个版本仅存储一次(tier-7 存量 + held-out,共 6,692,637 个元素,20,081.6 小时,2,694 个分片,1.04 TB tar 文件),每个元素带有
tier列表示包含它的最小层级索引。 - Held-out 划分:按与层级完全相同的规则抽取,与所有层级不相交(
tier = 8,通过 uid 验证零重叠),位于data/*/*/heldout/和index/*/*/heldout/,loader 配置为heldout。
四、数据配置(Configs)
tier0至tier7:分别为tier0至tierN目录的并集heldout:评估集de:单一语言(德语),所有层级en:单一语言(英语),所有层级real:真实来源数据synth:合成来源数据
五、数据加载方式
通过 datasets 库加载
python from datasets import load_dataset R = "laion/tts-scaling-ladder-de-en" t0 = load_dataset(R, "tier0") # 100 h t1 = load_dataset(R, "tier1") # 250 h t2 = load_dataset(R, "tier2") # 500 h t3 = load_dataset(R, "tier3") # 1,000 h t4 = load_dataset(R, "tier4") # 2,500 h t5 = load_dataset(R, "tier5") # 5,000 h t6 = load_dataset(R, "tier6") # 10,000 h t7 = load_dataset(R, "tier7") # 20,000 h ev = load_dataset(R, "heldout") # 80 h de = load_dataset(R, "de")
数据内容
每个元素包含:
- 音频:MP3 格式(与源仓库逐字节一致)
- MOSS 编码:
uint16 [T, 12],12.5 fps - JSON 记录:包含程序化配音提示(LAION-AI/procedural-voice-captions 格式,含 GENERAL 行和带逐句表达提示的 SCRIPT、
[pause X.Xs]标记和内联(Vocal Burst)标签),以及原始评分、语言、来源、源 uid、源许可证和时长
每个元素的 tar 成员:<uid>.mp3、<uid>.moss.npy、<uid>.json。
解码注意事项
vprof_original和vprof_repair来源为 48 kHz MP3,含两个相同声道,需用soundfile/torchaudio解码后取mean(axis=channels),切勿使用reshape(-1)(会产生半速信号,长度翻倍)。其他来源均为单声道。audio_sr和audio_channels在索引中。
六、选择规则
许可证过滤(评分前)
真实来源:emolia(DE+EN)、mls(仅 DE)、eurospeech(DE+EN)、kartoffelphon(DE)、commonvoice(仅 DE 和 EN 子集)。
合成来源:laion-voice-profiles-annotated(origin=original、origin=repair、vc_sidon)、laion/voice-acting-edge-top3、laion/voice-acting-reinterpretations-top3(MOSS 版本)。
排除:podcast、snippets、evasnippets、所有 Mediathek 内容、无文档许可证内容、laion/voice-acting-burst-audio、laion-emotional-trajectory-t80、laion/moss-voice-identity-repairs。
评分
所有指标按语言 × 来源单元格进行最小-最大归一化。关键指标包括 S_gen(真实度)、S_vb(混合度)、40 个 EmoNet 情绪维度得分、57 个 VoiceNet 维度得分。R_quality = S_gen + S_vb;R_emotion(e) = 3·S_emo,e + R_quality。
分层
每个单元格(语言 × 来源)在两条流程间对半分割:
- 流程 A(EmoNet,40 类别):按
R_emotion(e)排序,定义嵌套强度带(band 0–7),主排序为(band 升序,然后R_quality降序)。每类别配额为流程 A 体积的 1/40。 - 流程 B(VoiceNet,57 维度 × 10 分位数 = 570 桶):每个维度值域切分为 10 个等宽区间,桶内按
R_quality排序。每桶配额为流程 B 体积的 1/570。 - 去重:元素仅计数一次。固定顺序:先流程 A(40 类别按字母序),后流程 B(570 桶按可用候选小时数升序,稀缺优先)。
- 嵌套:按主排序遍历,累积小时数,元素获得
tier = min{N : cum_h ≤ q(N) + dur/2}。
七、各来源许可证
| 来源 | origin | 音频许可证 | 备注 |
|---|---|---|---|
emolia |
real | CC-BY-4.0 | |
commonvoice |
real | CC-0 | 仅 DE + EN 子集 |
eurospeech |
real | other — 议会条款各异 |
由项目负责人明确发布 |
kartoffelphon |
real | CC-BY-4.0 | 约 51% 为 LibriVox 公有领域 |
mls |
real | CC-BY-4.0 | 仅德语 |
vprof_original |
synth | CC-BY-4.0;生成器 Apache-2.0 | 500 个合成声音档案 |
vprof_repair |
synth | CC-BY-4.0 | 身份检查失败的重新录制 |
vc_sidon |
synth | CC-BY-4.0;Chatterbox VC (MIT) + SIDON | 与 vprof_original 同一 take 的语音转换孪生 |
dramabox_edge |
synth | CC-BY-4.0 | 266 个手写边缘案例 |
dramabox_reint |
synth | CC-BY-4.0 | MOSS 重新诠释版本 |
若使用场景不接受 other 许可证,可过滤 license 为 CC-BY-4.0 / CC-0(将移除 eurospeech;层级仍嵌套但不再严格平衡)。
八、平衡性(小时数)
各层级平衡
| tier | DE | EN | real | synth |
|---|---|---|---|---|
| 0 | 50.0 | 50.0 | 50.0 | 50.0 |
| 1 | 125.0 | 125.0 | 124.9 | 125.0 |
| 2 | 250.0 | 250.0 | 250.0 | 250.0 |
| 3 | 500.0 | 500.0 | 500.0 | 500.0 |
| 4 | 1,250.0 | 1,250.1 | 1,250.0 | 1,250.1 |
| 5 | 2,500.0 | 2,500.3 | 2,500.1 | 2,500.2 |
| 6 | 5,000.3 | 5,000.5 | 5,000.3 | 5,000.4 |
| 7 | 10,000.6 | 10,000.9 | 10,000.6 | 10,000.9 |
| held-out | 40.1 | 40.1 | 40.0 | 40.1 |
各(单元格,流程)目标值(tier 0–7):12.5 / 31.25 / 62.5 / 125 / 312.5 / 625 / 1,250 / 2,500 小时。64 个层级值最大偏差 0.204%;8 个 held-out 值最大偏差 0.238%,均在 0.25% 内。
各来源小时数(tier 7 + held-out)
| 来源 | DE real | EN real | DE synth | EN synth |
|---|---|---|---|---|
commonvoice |
170.0 (131,515) | 69.6 (57,578) | — | — |
dramabox_edge |
— | — | 156.3 (19,747) | 2,547.5 (310,985) |
dramabox_reint |
— | — | 52.5 (12,805) | 61.4 (15,617) |
emolia |
2,091.4 (669,330) | 4,915.0 (1,505,156) | — | — |
eurospeech |
608.1 (140,828) | 32.8 (7,916) | — | — |
kartoffelphon |
2,116.6 (611,467) | 2.9 (923) | — | — |
mls |
34.1 (7,889) | — | — | — |
vc_sidon |
— | — | 2,050.7 (709,047) | 690.4 (394,290) |
vprof_original |
— | — | 2,218.8 (747,642) | 1,338.1 (651,627) |
vprof_repair |
— | — | 542.0 (351,342) | 383.3 (346,933) |
九、提示(Prompt)结构
rec["prompt"] / 索引 prompt 由 LAION-AI/procedural-voice-captions 的 captioner 离线生成(main 分支,PR #4:17 类 ×2 头和基于能量的停顿校正),tags 模板,确定性种子 = stable_hash(uid):
- GENERAL:按 |z|·可靠性取前 5 个 VoiceNet 维度、前 3 个情绪、真实度、爆发混合,始终包含年龄/性别/音域/语速,相对于打包的域内基线进行 z 标准化。
- SCRIPT:每句一行
(delivery cue) sentence text。句子在对齐词的句末标点处切分。每句提示均源自片段的全局评分(记录存储句子时间戳以便后续逐句重新评分)。措辞按句子确定性轮换。 [pause X.Xs]:连续词或句子之间 ≥ 0.30 秒的间隔,基于存储的词时间戳经基于能量的词尾校正后测量(end_span保留原始值)。词时间戳来自语料对齐(LAION 语料用 MMS-FA,DramaBox 来源用 Parakeet)。(Vocal Burst):源标注中保留的定位器/分类器 v2 跨度,写在发生处的词间隔(BURST_LABEL_SOURCE=v2)。prompt_x2为使用 17 类 x2 头命名跨度的同一提示(BURST_LABEL_SOURCE=x2,按召回分层的措辞:精确类别 /Class?/ 家族词 /Vocal Burst),存在于有vb2_*重新标注的元素中(6,692,637 个元素中的 3,689,357 个)。
十、执行者假设
规范中留空、由执行者采用的两项假设:
- 两条流程各占 50%:每个单元格内,一半体积由流程 A 填充,一半由流程 B 填充。
- 单一存储、单一
tier列:整个版本仅存储一次,每个元素携带tier= 包含它的最小层级。Tier K 定义为tier <= K,嵌套由构造保证而非通过提供八份重叠副本来实现。
其余执行者选择(池定义、分位数边界、去重顺序、桶不足处理、语言判定)在规则中标记为 [A]。