
遇见数据集

sensenova/SenseNova-Vision-Corpus-50M

收藏
Hugging Face2026-07-15 更新2026-07-22 收录
官方服务:

资源简介:

SenseNova Vision Corpus 50M(SN-VC-50M)是一个大规模多模态视觉语料库,专为统一训练多种视觉理解和几何导向任务而设计。该数据集旨在解决现有公共视觉数据集的常见局限性,例如注释不完整、跨任务不一致或无法直接解码为训练就绪的多模态监督。SN-VC-50M将开源视觉数据组织为四个任务家族:结构化视觉理解、分割、密集几何预测和多视图视觉几何。在这些家族中,该版本包含73个数据集-任务条目,覆盖10种任务类型。具体规模包括:结构化视觉理解18.9M帧、分割1.3M帧、密集几何预测17.3M帧、多视图视觉几何12.5M帧。为构建训练兼容的监督信息,数据集使用任务专门化的处理流程:对于结构化理解,采用Rex-Omni数据构建流程生成检测和OCR风格的样本;对于密集几何,利用MoGe-2来稠密化稀疏深度和表面法线注释并提高场景多样性;对于多视图场景,使用LingBot-Depth补充不完整的稀疏深度信息;对于分割,应用严格的对齐检查以确保文本区域描述、颜色图例和分割掩码之间的一致性。为避免重新分发公共源数据集中重复的原始RGB图像,JSONL训练示例保留相应的相对文件路径,而不是复制所有原始RGB资源。用户需要将本地数据集根目录与JSONL文件中记录的图像文件路径对齐,以正确加载视觉输入。

SenseNova Vision Corpus 50M (SN-VC-50M) is a large-scale multimodal visual corpus designed specifically for unified training of diverse visual understanding and geometry-oriented tasks. This dataset aims to address common limitations of existing public visual datasets, such as incomplete annotations, cross-task inconsistencies, and inability to be directly decoded into training-ready multimodal supervision. SN-VC-50M organizes open-source visual data into four task families: structured visual understanding, segmentation, dense geometry prediction, and multi-view visual geometry. Within these families, this version includes 73 dataset-task entries covering 10 task types. The specific scale is as follows: 18.9M frames for structured visual understanding, 1.3M frames for segmentation, 17.3M frames for dense geometry prediction, and 12.5M frames for multi-view visual geometry. To create training-compatible supervision information, the dataset adopts task-specialized processing workflows: For structured visual understanding, the Rex-Omni data construction pipeline is used to generate detection and OCR-style samples; For dense geometry prediction, MoGe-2 is utilized to densify sparse depth and surface normal annotations and improve scene diversity; For multi-view visual geometry scenarios, LingBot-Depth is employed to supplement incomplete sparse depth information; For segmentation, strict alignment checks are applied to ensure consistency among text region descriptions, color legends, and segmentation masks. To avoid redistributing duplicate raw RGB images from public source datasets, JSONL training examples retain their corresponding relative file paths instead of copying all raw RGB resources. Users must align their local dataset root directory with the image file paths recorded in the JSONL files to properly load visual inputs.
提供机构:
sensenova
搜集汇总
数据集介绍
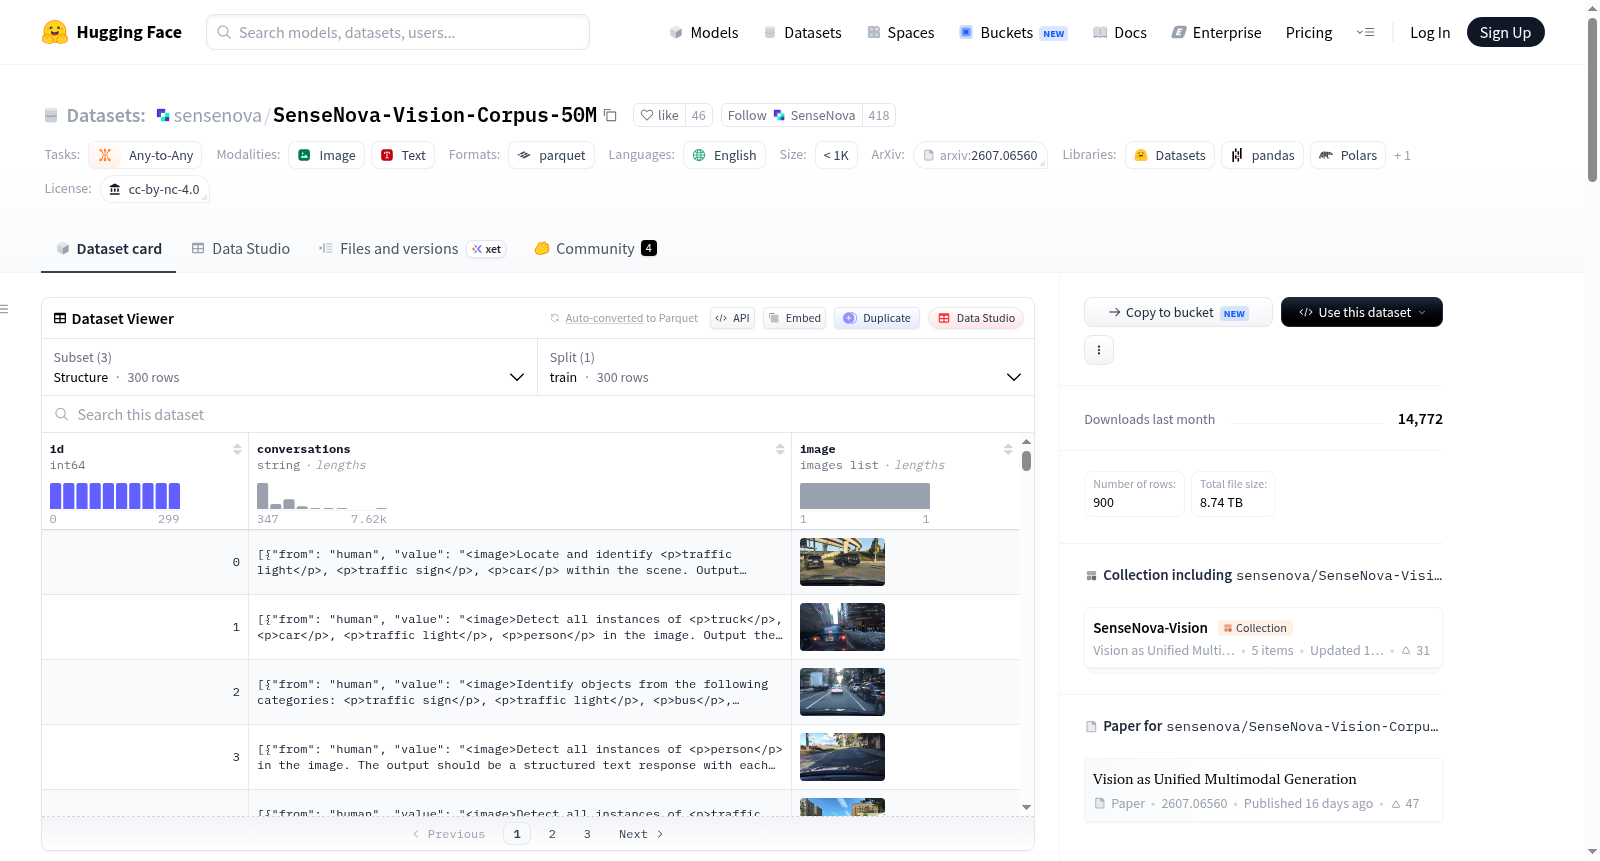
sensenova/SenseNova-Vision-Corpus-50M 数据集图片
构建方式
SenseNova-Vision-Corpus-50M(SN-VC-50M)是一个面向统一多模态生成的大规模视觉语料库。其构建过程针对现有公开数据集标注不完整、跨任务不一致等问题,设计了任务特化的数据整理流程。对于结构化视觉理解,采用Rex-Omni数据构建管线生成检测与OCR类样本;在密集几何预测方面,借助MoGe-2模型对稀疏深度与表面法向标注进行稠密化处理,并提升场景多样性;针对多视角场景,利用LingBot-Depth补全稀疏深度信息;在分割任务中,通过严格的对齐校验确保文本区域描述、颜色图例与分割掩码的一致性。最终语料库整合了来自73个数据集-任务条目的50M帧数据,涵盖结构化理解、分割、密集几何预测与多视角几何四大任务族。
特点
该数据集的一大特色在于其多任务统一性与标注质量的可控性。通过统一的JSONL格式组织训练样本,不同任务的标注信息得以在同一框架下高效调用。数据集不直接分发原始RGB图像,而是保留相对文件路径,避免冗余存储并尊重原始数据版权。另一突出特点是引入了专门设计的资产目录,其中包含经稠密化处理的深度图、法向图及重建数据等提取后的监督信号,便于直接用于模型训练。此外,数据集覆盖了10种任务类型,从目标检测、OCR到深度估计与多视角重建,为多模态生成模型的预训练与微调提供了丰富的监督来源。
使用方法
使用该数据集时,用户需首先根据Dataset_download_description.md中提供的官方下载地址获取完整的原始数据集,并将本地数据集根目录与JSONL文件中记录的相对图像路径对齐。随后,可将各任务对应的JSONL文件(如dense_geometric_prediction/coco_total_unified_depth_edit_regenerated.jsonl)作为索引加载训练样本,同时从预下载的资产目录中读取对应的稠密深度、法向或分割掩码等监督信号。为快速体验数据格式,HuggingFace仓库中提供了三个配置下的parquet样本文件(结构、几何与分割),每份包含300条记录,可用于验证数据加载流程。
背景与挑战
背景概述
SenseNova-Vision-Corpus-50M(简称SN-VC-50M)是由商汤科技旗下的OpenSenseNova团队于2025年构建并发布的大规模多模态视觉语料库,其相关研究论文《Vision as Unified Multimodal Generation》发表于arXiv(编号2607.06560)。该数据集旨在解决现有公开视觉数据集中普遍存在的标注不完整、不同任务间不一致以及难以直接转化为训练所需的多模态监督信号等核心问题。SN-VC-50M整合了来自73个数据集-任务条目的逾5000万帧图像,涵盖结构化视觉理解、分割、密集几何预测和多视角视觉几何四大任务家族,为统一的多模态视觉生成研究提供了高质量、大规模的训练基准,显著推动了视觉基础模型在跨任务泛化与精细化感知领域的发展。
当前挑战
该数据集面临的挑战首要在于解决视觉任务统一建模中的领域难题:现有数据集多针对单一任务设计,缺乏跨任务、跨模态的标准化监督信号,导致模型难以在检测、分割、深度估计等异构任务间共享知识。构建过程中,团队面临标注不完整与不一致的挑战,例如稀疏深度与表面法向信息的缺失,以及分割掩码与文本描述间的对齐偏差。为此,他们开发了任务特化的数据管线,如利用MoGe-2模型补全稀疏深度标注、采用LingBot-Depth完善多视角深度信息,并通过严格对齐校验确保分割数据的一致性,同时避免重新分发原始RGB图像,转而采用相对文件路径以保护源数据版权与隐私。
常用场景
经典使用场景
在视觉与语言多模态生成的研究浪潮中,SenseNova-Vision-Corpus-50M(SN-VC-50M)以其宏大的规模和精细的任务划分,成为了统一视觉理解与几何感知任务的基石数据集。其经典使用场景涵盖了结构化视觉理解、图像分割、密集几何预测以及多视角视觉几何四大任务族,共计10种具体任务类型,为从基础感知到高级推理的多模态模型训练提供了丰富且对齐的监督信号。研究人员常将其作为预训练或联合训练的核心语料,以赋予模型同时处理检测、OCR、深度估计、表面法线预测、分割和三维重建等多样化视觉挑战的能力,从而推动通用视觉生成模型的发展。
衍生相关工作
SN-VC-50M的发布催生了一系列开创性的研究工作。首先,其配套发表的论文《Vision as Unified Multimodal Generation》基于该数据集训练了SenseNova-Vision-7B-MoT模型,验证了联合多任务学习的有效性,为视觉生成模型树立了新标杆。随后,研究者基于其结构化理解和几何预测子集,衍生出针对特定领域如遥感图像分析(DOTAv2、FAIR1M)和街景理解(Cityscapes、KITTI)的微调基准。此外,该数据集的策展策略——如利用MoGe-2进行稀疏标注稠密化——被后续工作广泛借鉴,启发了更多关于高效数据合成与多模态对齐技术的探索,持续推动着视觉AI研究的边界拓展。
数据集最近研究
最新研究方向
SenseNova-Vision-Corpus-50M作为一项面向统一多模态生成的大规模视觉语料库,近期研究聚焦于克服现有公开数据集的标注不完整、跨任务不一致及难以直接用于多模态监督训练等核心瓶颈。该数据集通过结构化视觉理解、分割、密集几何预测及多视角视觉几何四大任务体系,整合73个数据集-任务条目覆盖10种任务类型,并采用任务特化的数据构建管道,如借鉴Rex-Omni进行检测与OCR样本生成、利用MoGe-2提升深度与表面法向量的场景多样性、以及严格校验分割标注的一致性。这一系统性整合推动了视觉领域从孤立任务建模向统一多任务生成范式的跃迁,在自动驾驶、三维重建及通用视觉智能等前沿应用中具有深远意义,为构建更强大的多模态基础模型奠定了坚实的数据基石。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

