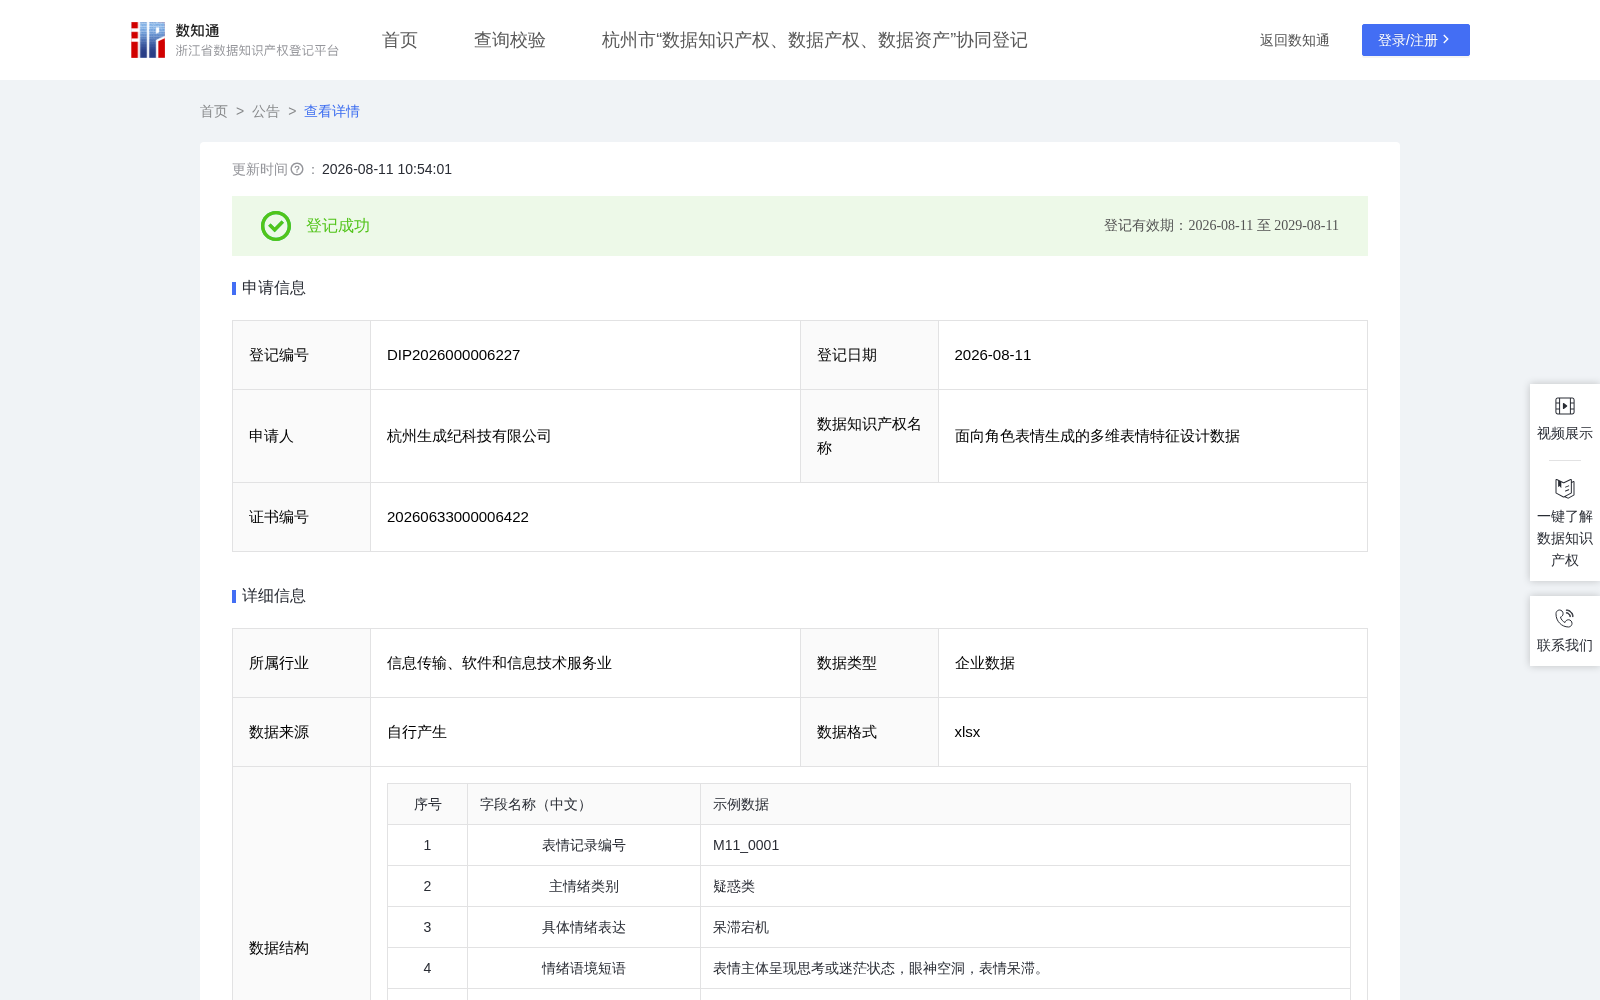
面向角色表情生成的多维表情特征设计数据
收藏资源简介:
本数据应用于数字内容创作和AI辅助角色表情生成场景,主要服务于角色表情设计、表情包素材制作、短视频情绪插图匹配、角色IP表情扩展、AI图像生成提示词构造和表情生成质量校验。 通过对角色表情的情绪语义、表情气质、五官结构、五官布局与变形、光影色彩、镜头姿态、观众感受和生成转译字段进行结构化整理,本数据能够将原本较难复用的表情设计经验转化为可检索、可筛选、可迁移和可用于生成的表情特征文本数据。 本数据可用于统一基准角色表情生成、原创角色表情迁移、表情包自动组装、短视频情绪素材匹配、数字内容创作辅助和后续原创表情图像数据包建设,从而提升角色表情生成的准确性、一致性和内容生产效率。加工前数据主要来源于申请主体内部角色表情生成与表情包素材建设项目,原始形态包括表情分类规则、表情特征字段模板、候选表情描述文本、生成约束规则、人工筛选记录和质量校验结果等。相关数据在形成初期存在字段粒度不完全一致、情绪表达口径不统一、部分描述不够结构化、生成指令可复用性不足等情况,需进一步整理为主题明确、字段统一、可检索、可复用的多维表情特征设计数据。 数据处理采用“自研框架设计 + 字段体系建设 + AI辅助生成 + 人工筛选修正 + 文本清洗归一 + 质量校验”的流程。申请人首先围绕角色表情生成、表情包制作和数字内容创作场景,建立包含情绪语义、表情气质、五官状态、脸部变形、镜头姿态、观众感受、核心视觉锚点、生成配方和反向约束等内容的多维表情特征框架;随后据此设计主情绪类别、具体情绪表达、表情气质、眼部状态、眉部状态、嘴部状态、脸部状态、变形程度、光影色彩、镜头姿态、观众感受、核心视觉锚点、表情生成配方、反向生成约束等结构化字段,并通过AI辅助生成候选记录。 在后续整理过程中,申请人对候选记录进行人工筛选、字段补全、语义校准、重复排查、文本清洗和格式归一,剔除表达不完整、情绪指向不清晰、生成指令不稳定、字段结构不符合要求的记录,并对保留数据进行统一命名、统一分类和统一质量标记,使其从零散的表情描述文本转化为可管理、可调用、可迁移的表情特征设计数据。处理后的数据不涉及个人信息、个人敏感信息、真人身份识别、人脸识别、未成年人个人信息或特殊行业敏感数据。 处理后的数据主要包括1000条以上结构化表情特征文本记录,可用于角色表情检索、表情包素材制作、统一基准角色表情生成、原创角色表情迁移、短视频情绪素材匹配、AI图像生成提示词构造、表情生成质量校验和数字内容创作辅助等场景。数据整体具备明确的主题边界、字段结构、处理规则和后续转化应用价值。