
WithinUsAI/The_Browsing_From_WithIn_10k
收藏官方服务:
资源简介:
The_Browsing_From_WithIn_10k是一个前沿质量的数据集,旨在训练高级网络自主代理语言模型,专注于多跳浏览、跨多个来源的导航、跨源比较、矛盾检测、证据协调和合成。
The_Browsing_From_WithIn_10k is a cutting-edge high-quality dataset aimed at training advanced web autonomous agent language models, focusing on multi-hop browsing, navigation across multiple sources, cross-source comparison, contradiction detection, evidence coordination and synthesis.
提供机构:
WithinUsAI搜集汇总
数据集介绍
构建方式
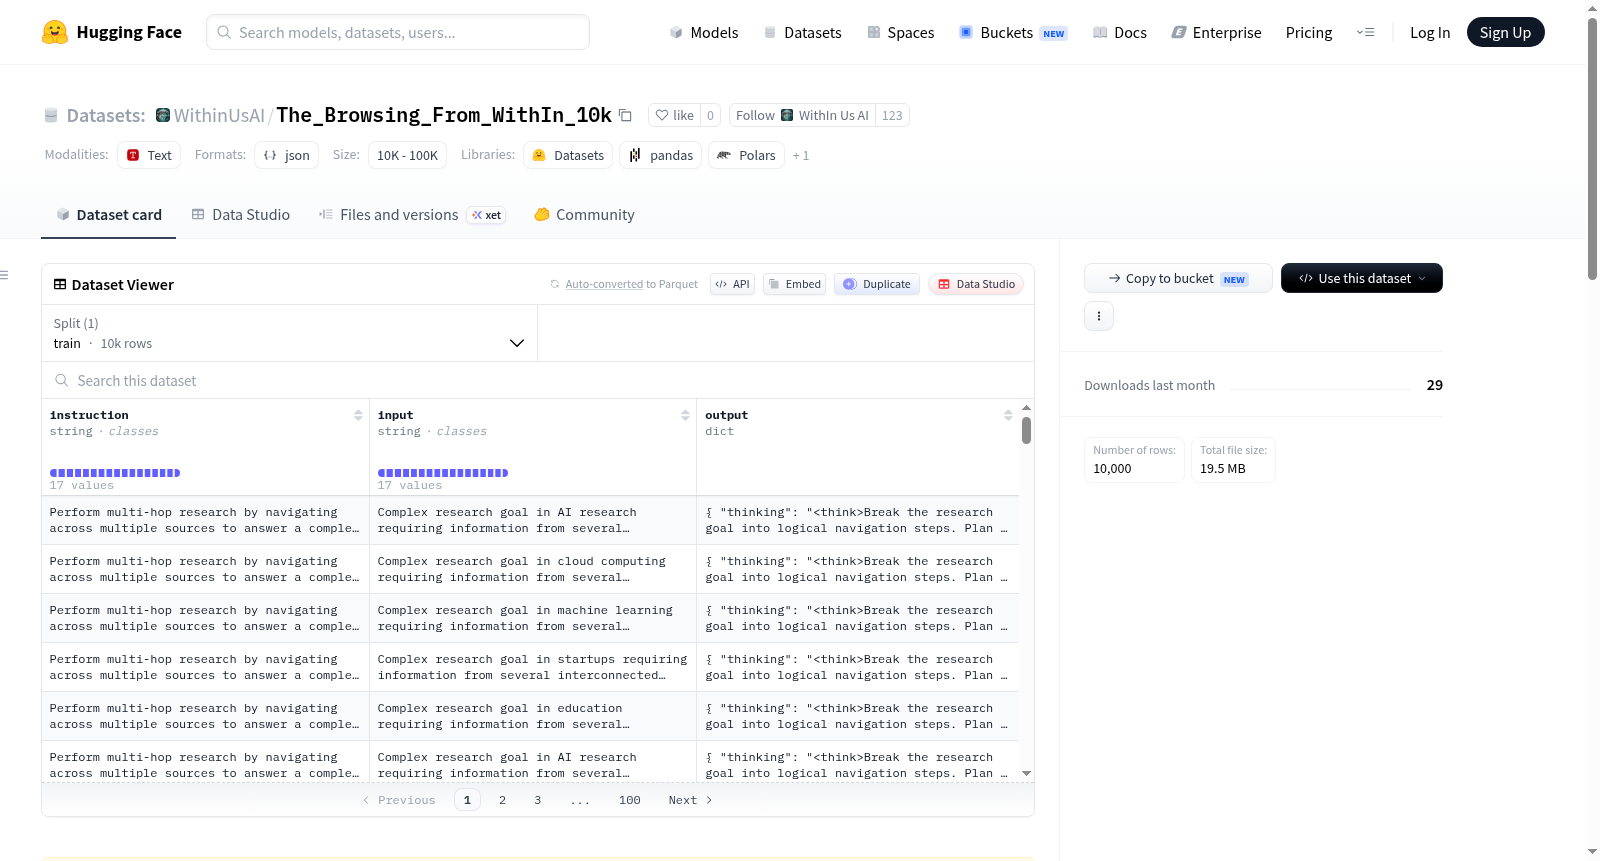
该数据集由WithIn Us Ai团队精心构建,包含10,000条独特的专业级示例,以JSONL格式存储。每条记录精心设计了指令、输入与输出三部分,输出中嵌入思维链、研究目标、导航路径、访问来源、跨源发现、冲突检测及最终综合等内容,旨在模拟多跳浏览与跨源合成的复杂研究流程。数据集覆盖人工智能、机器学习、软件工程、网络安全、医学、科学、金融、商业、初创企业、基础设施及云计算等多个领域,确保无重复或低质量内容,遵循MIT许可协议。
特点
数据集的核心特点在于其前沿质量与结构化设计,专注于训练语言模型在多源浏览、跨源比较、矛盾检测、证据调和及信息综合等复杂任务上的能力。每条数据均包含显式的思考过程与导航推理,通过<think>标签封装,增强了模型的可解释性与实用性。领域覆盖广泛且专业,从科技前沿到商业实践,为构建高级自主网络代理提供了坚实的训练基础。数据严格去重,保证了训练样本的独特性与高质量。
使用方法
该数据集适用于微调具备多跳浏览与跨源合成能力的语言模型。建议与The_Web_From_WithIn_10k及The_Extraction_From_WithIn_10k数据集配套使用,以渐进式提升网络代理技能。使用时可直接解析JSONL格式数据,利用其中的指令与输入构建训练样本,将输出中的思考链与综合结果作为目标标签。适合于监督微调或基于指令的强化学习场景,重点优化模型在多源信息检索与冲突分析中的准确性与流畅性。
背景与挑战
背景概述
随着大型语言模型在复杂任务中的应用日益广泛,网络浏览与信息合成能力成为智能体研究的前沿方向。The_Browsing_From_WithIn_10k数据集由WithIn Us Ai团队于近期创建,版本1.0,专为训练具备多跳浏览与跨源合成能力的自主网络智能体模型而设计。其核心研究问题是提升语言模型在多步信息检索、交叉来源对比、矛盾检测及证据整合方面的性能。该数据集涵盖人工智能、机器学习、软件工程、网络安全、医学、科学、金融等十余个专业领域,共计10,000条高质量样本,对推动自主化网络研究智能体的发展具有重要影响。
当前挑战
该数据集旨在解决语言模型在真实网络环境中进行多跳、多源信息整合的领域问题挑战,包括跨页面导航的连贯性、矛盾信息的识别与调和、以及复杂专业知识的综合表述。在构建过程中,团队面临确保10,000条样本全部为独特且高质量的专业案例的难题,需避免重复与低质内容;同时,设计包含思维链、导航路径、访问来源、冲突检测等细粒度结构标签的JSONL格式,要求严格定义多步推理与合成流程,对数据生成与质量控制提出了较高标准。
常用场景
经典使用场景
在构建具备复杂网络研究能力的自主语言智能体时,Browsing_From_WithIn_10k数据集扮演着基石性角色。该数据集专为训练大语言模型在真实网络环境中执行多跳浏览而设计,涵盖了从多源导航、跨来源信息比较到矛盾检测与证据协调的全链路任务。研究者可借助该数据集的10,000个高质量专业样例,引导模型逐步掌握在多领域文献中进行深度信息检索与综合的能力,从而显著提升智能体在开放网络场景下自主完成科研调研的流畅度与准确性。
实际应用
在实际产业环境中,该数据集培养的网络智能体可直接部署于专业科研辅助系统、技术文档自动梳理平台及竞争情报分析工具中。例如,在药物研发领域,模型可自动遍历多个临床数据库,对比不同试验结果并识别潜在矛盾点,帮助研究人员快速锁定关键证据;在金融分析场景下,智能体能够跨多家财报与新闻源进行多跳检索,综合形成对市场趋势的辩证判断。这些应用极大释放了人力在信息核查与综合表述上的负担,使得高质量的跨源研究流程得以自动化实现。
衍生相关工作
基于Browsing_From_WithIn_10k,研究者已发展出多种增强型工作。其中最突出的方向包括将多跳浏览能力与抽取式问答模型结合,形成了能够在网络环境中自主定位并整合分散式信息的联合推理框架;此外,该数据集也被用作强化学习环境中奖励模型的微调数据,以训练智能体在导航过程中优化访问路径与证据权重分配策略。这些衍生工作进一步拓展了该数据集对自主智能体研发的赋能深度,为更接近人类专家级网络研究能力的通用智能体奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成


