
遇见数据集

justtherightsize/it-slama-10

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

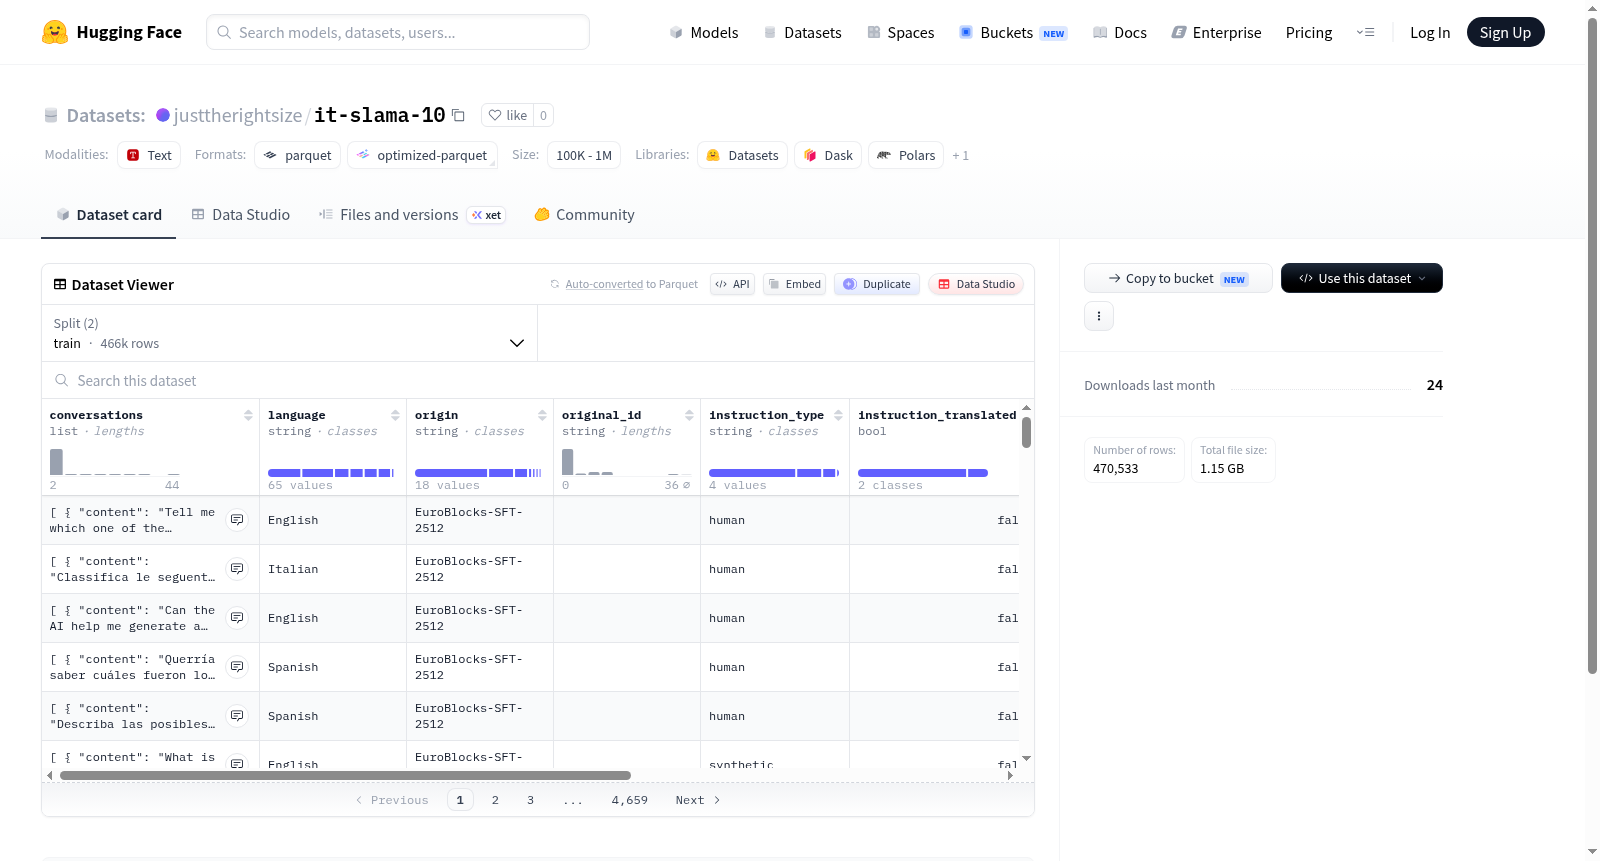
该数据集是一个多语言对话数据集,专为监督微调(SFT)设计,包含约46.7万个训练样本和约4,700个测试样本。数据集特征包括对话内容(角色和内容)、语言、来源、原始ID、指令类型(如问答、编码、创意写作、数学推理等)、指令是否翻译、输出类型、输出是否翻译、来源数据集(如EuroBlocks、Bactrian-X、OSCAR、WikiHow等)和语言组。数据覆盖多种任务类型和来源,支持多语言处理,适用于自然语言处理模型的训练和评估。

This dataset is a multilingual dialogue dataset designed for supervised fine-tuning (SFT), containing approximately 467,000 training samples and about 4,700 test samples. Features include conversations (role and content), language, origin, original ID, instruction type (e.g., question answering, coding, creative writing, mathematical reasoning), whether instruction is translated, output type, whether output is translated, origin dataset (e.g., EuroBlocks, Bactrian-X, OSCAR, WikiHow), and language group. It covers multiple task types and sources, supports multilingual processing, and is suitable for training and evaluating natural language processing models.
提供机构:
justtherightsize
搜集汇总
数据集介绍
justtherightsize/it-slama-10 数据集图片
构建方式
it-slama-10 数据集是通过整合来自多个公开来源的意大利语指令数据构建而成,包括 EuroBlocks-SFT 系列、bactrian-x、muri-it 系列等数十个数据集。每条样本包含多轮对话内容,标注了语言、来源、原始 ID、指令类型与输出类型等信息,且部分内容经过翻译验证。数据最终划分为训练集(约46.6万条)和测试集(约4706条),以 JSON 格式存储。
特点
本数据集囊括了涵盖问答、创作、推理、编程、摘要等广泛指令类型的意大利语对话语料,并明确区分各样本的原始数据集来源,便于分析不同领域数据的分布。同时,通过对指令与输出的翻译状态进行标记,提升了多语言场景下的可用性,为意大利语大语言模型的指令微调与评估提供了高质量的基准资源。
使用方法
使用者可通过 Hugging Face Datasets 库直接加载 it-slama-10,利用配置文件指定 'train' 或 'test' 子集。在微调模型时,可将 'conversations' 字段中的多轮对话按角色与内容组装成标准输入格式,并依据 'language' 与 'origin' 字段筛选特定来源的数据,灵活适配不同的训练需求。
背景与挑战
背景概述
在大规模语言模型(LLMs)的浪潮中,高质量、多语言尤其是低资源语言的无监督微调(SFT)数据集的匮乏,成为了制约模型在多语言环境下性能提升的关键瓶颈。it-slama-10数据集应运而生,其创建时间可追溯至2024年,由致力于推动多语言自然语言处理(NLP)发展的研究团队构建。该数据集的核心研究问题在于,如何整合来自EuroBlocks-SFT、bactrian-x等多源语料库,构建一个面向意大利语的高质量指令遵循数据集,以填补小语种在指令微调领域的空白。it-slama-10通过精心筛选与翻译校对,汇聚了超过46万条训练样本,涵盖对话、编码、推理、创意写作等多元任务类型,其发布为研究意大利语LLM的指令遵循能力、跨语言迁移学习以及低资源语言SFT数据构建方法论提供了宝贵的基础设施,对推动小语种语言模型的发展具有里程碑式的影响。
当前挑战
it-slama-10数据集所解决的领域核心挑战在于,针对意大利语这种低资源语言,缺乏大规模、高质量、多样化的指令微调数据,导致意大利语LLM在复杂指令遵循、多轮对话及专业任务上的表现远逊于英语模型。构建过程中面临的挑战亦十分严峻:首先,数据源结构异构,需将来自EuroBlocks-SFT(包含2512个任务)、bactrian-x、muri-it等多达30余种不同来源与格式的数据集进行统一化处理与对齐;其次,语言质量把控困难,由于大量数据来源于合成生成或机器翻译,需通过人工与自动校验机制剔除语义偏差与噪声,确保意大利语指令的自然度与准确性;最后,类别平衡问题突出,在融合知识推理、数学推理、角色扮演等多样任务类型时,需精心设计采样策略以避免模型训练偏向高频任务类别,从而保证指令微调后的模型在各类任务上具备均衡的能力。
常用场景
经典使用场景
it-slama-10数据集汇聚了来自多个高质量意大利语来源的指令微调对话样本,涵盖EuroBlocks、bactrian-x、chatcorpus等经典资源,其核心应用场景在于为低资源语言大模型的指令跟随能力提供训练支撑。该数据集特别适合用于构建和评估意大利语对话系统,通过其丰富的多轮对话结构与多样化的指令类型,能够有效提升模型在意大利语环境下的语义理解与生成质量,是推动非英语大语言模型发展的关键数据基石。
衍生相关工作
该数据集的衍生产出激发了多项经典工作,例如基于其数据划分的跨语言指令微调方法研究,以及针对意大利语模型的对齐优化技术。此外,it-slama-10常被用作基准测试集来比较不同翻译策略对模型性能的影响,催生了如muri-it系列数据构建范式的改进。这些工作进一步拓展了多语言指令微调的理论框架,凸显了高质量非英语数据集在推动全球AI普惠化中的核心地位。
数据集最近研究
最新研究方向
随着多语言大语言模型在低资源语言场景下的持续拓展,意大利语指令微调数据集 it-slama-10 的构建揭示了非英语语言对齐优化的重要方向。该数据集整合了来自 EuroBlocks、bactrian-x、muri-it 等多个高质量来源的对话与指令数据,涵盖问答、写作、推理、代码生成等丰富任务类型,并通过语言标注与翻译状态字段实现对多源异构数据的精细管理。当前,面向意大利语的模型微调研究正聚焦于如何在保持语言多样性的同时,提升指令遵循能力与文化适应性。it-slama-10 的出现为欧洲非英语语言的模型对齐研究提供了关键数据基座,推动了区域语言人工智能生态的稳健发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

