
遇见数据集

amalia-llm/PorTEXTO

收藏
Hugging Face2026-07-06 更新2026-07-22 收录
官方服务:

资源简介:

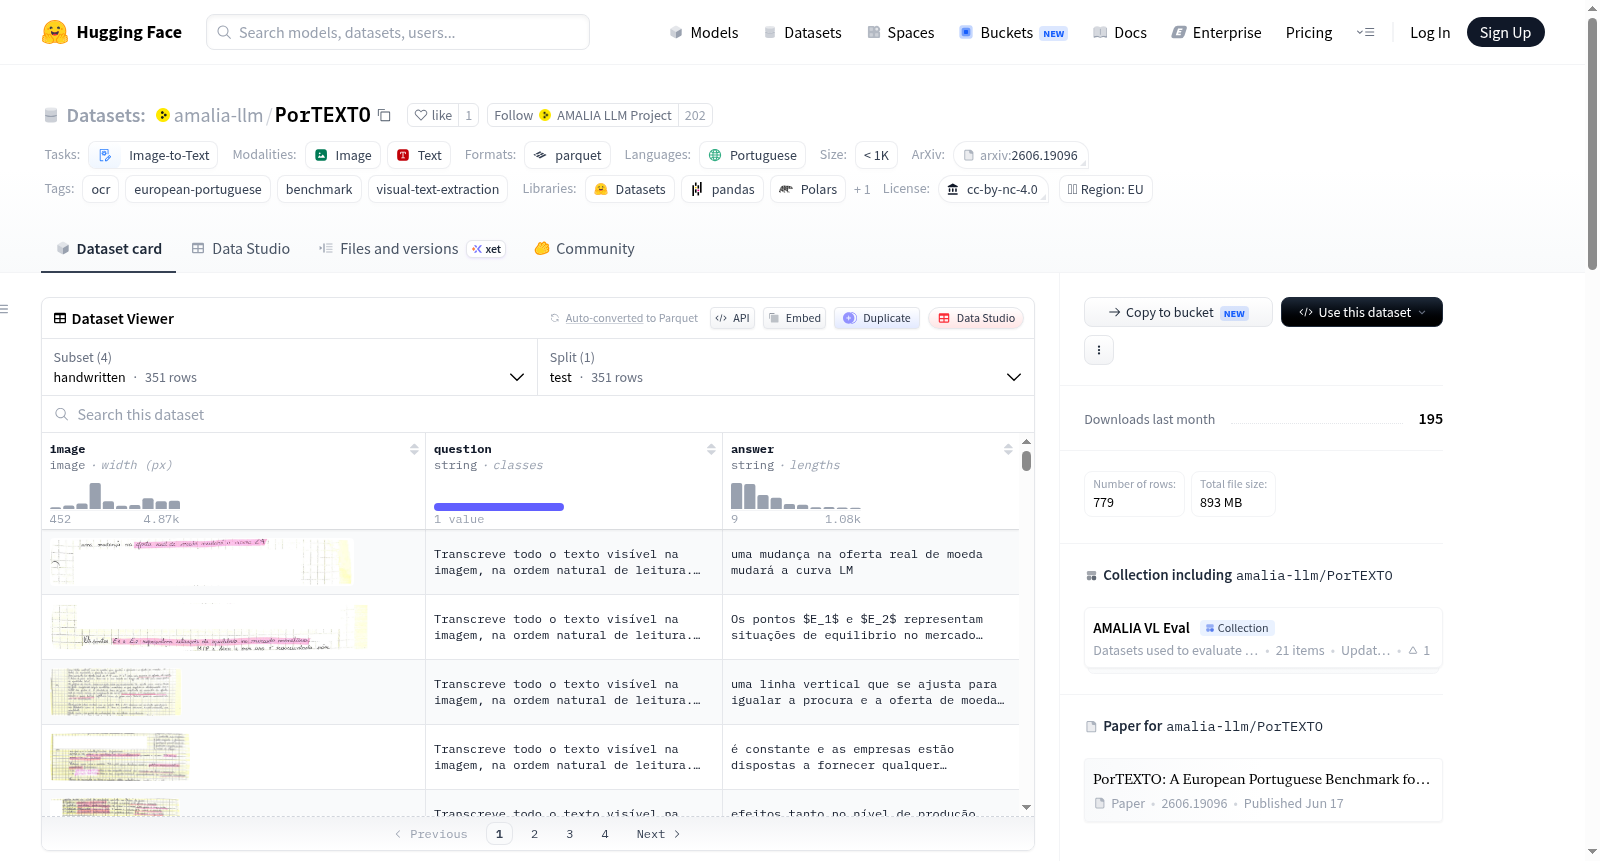
PorTEXTO是第一个针对当代和文化相关的欧洲葡萄牙语(pt-PT)视觉文本提取的基准数据集。它专注于现代、真实世界的葡萄牙语内容,包括手写笔记、野外场景文本和合成图像,为OCR(光学字符识别)和大型视觉语言模型提供了一个具有挑战性的评估套件。数据集包含四个配置:handwritten(从扫描文档中裁剪的手写文本区域,351个样本)、handwritten_full_page(全页扫描的手写文档,121个样本)、synthetic(为pt-PT OCR评估合成的文本图像,200个样本)和in_the_wild(在自然环境中捕获的真实世界场景文本,107个样本),总样本数为779。每个样本包括图像、标准pt-PT转录提示和真实转录。数据集采用cc-by-nc-4.0许可,仅限非商业用途,并需注明出处。

PorTEXTO is the first benchmark dataset for visual text extraction targeting contemporary and culturally relevant European Portuguese (pt-PT). It focuses on modern, real-world Portuguese content, including handwritten notes, in-the-wild scene text, and synthetic images, acting as a challenging evaluation suite for Optical Character Recognition (OCR) and Large Vision-Language Models (LVLMs). The dataset includes four configurations: handwritten (handwritten text regions cropped from scanned documents, 351 samples), handwritten_full_page (full-page scanned handwritten documents, 121 samples), synthetic (text images synthesized for pt-PT OCR evaluation, 200 samples), and in_the_wild (real-world scene text captured in natural environments, 107 samples), with a total of 779 samples. Each sample consists of an image, a standard pt-PT transcription prompt, and the ground-truth transcription. The dataset is licensed under CC BY-NC 4.0, for non-commercial use only, and proper attribution is required.
提供机构:
amalia-llm
搜集汇总
数据集介绍
amalia-llm/PorTEXTO 数据集图片
构建方式
PorTEXTO数据集是首个专注于当代与具有文化相关性的欧洲葡萄牙语(pt-PT)视觉文本提取的基准测试。该数据集精心构建了四个子集:手写文本区域(handwritten)包含351张从扫描文档中裁剪的手写文本片段;全页手写文档(handwritten_full_page)提供121张完整页面扫描;合成图像(synthetic)通过自动化手段生成了200张用于评估的文本图片;自然场景文本(in_the_wild)涵盖107张在真实环境中捕获的场景文字。所有样本均以图像、标准转录提示词及真实文本标签的结构化形式呈现,共计779个测试样本。
使用方法
使用PorTEXTO数据集时,用户可通过HuggingFace平台加载其四个配置之一,例如`load_dataset('AMALIA-llm/PorTEXTO', 'handwritten')`。每个样本包含图像字段、用于提示模型的`question`字段以及作为答案基准的`answer`字段。该数据集专为评估OCR模型与大型视觉语言模型在葡萄牙语文本提取任务上的表现而设计,研究人员可直接将其作为测试集使用,以评估模型在跨领域文本识别中的鲁棒性。数据集遵循CC-BY-NC 4.0许可协议,仅可用于非商业目的。
背景与挑战
背景概述
PorTEXTO是首个聚焦当代且文化相关的欧洲葡萄牙语(pt-PT)视觉文本提取的基准数据集,由João Cardeira、Diogo Glória-Silva等研究人员于2026年发布,隶属于葡萄牙的AMALIA项目。该数据集旨在解决现有OCR基准多集中于历史文献或高资源语言、缺乏对现代葡萄牙语内容系统性评估的问题。通过构建包含手写文本、场景文本和合成图像的779个样本,PorTEXTO为评估光学字符识别(OCR)与大型视觉语言模型在低资源语言上的表现提供了标准化测试平台,并揭示了模型从合成数据到真实样本的显著性能下降现象,强调了多语言专有数据对模型优化的重要性。
当前挑战
PorTEXTO所解决的领域挑战在于欧洲葡萄牙语视觉文本提取的评估空白,现有基准难以反映模型在真实开放场景中的适应能力。具体而言,手写笔记的笔迹变异、场景文本的光照与遮挡干扰、以及合成数据与真实分布间的领域差异构成了主要技术难题。在构建过程中,数据集面临图片采集多样性和标注一致性的挑战,需从不同来源获取涵盖历史文档、现代场景与人工生成的图像,并依赖高级语言模型进行大规模转录以确保文本精度,同时限制在非商业用途下平衡数据可用性与版权合规性。
常用场景
经典使用场景
PorTEXTO作为首个面向当代欧洲葡萄牙语视觉文本提取的基准数据集,其经典使用场景集中在评估与对比各类光学字符识别(OCR)模型及多模态大语言模型在葡语文本转录任务上的表现。数据集精心构建了四个差异化子集:手写文本裁剪区域、全页手写文档、合成文本图像以及真实场景文本,覆盖从受控条件到自然环境的多种视觉复杂度。研究者通常将PorTEXTO作为标准测试床,用以衡量模型在真实世界葡语文本上的泛化能力,尤其关注从合成数据到样本分布的迁移性能落差。
解决学术问题
该数据集精准回应了低资源语言视觉文本提取领域长期存在的评估基准缺失问题。现有OCR基准多聚焦于高资源语言或历史文献,忽略了当代欧洲葡萄牙语的独特书写风格与文化语境。PorTEXTO通过提供现代、真实且文化相关的测试样本,使学术界能够系统性揭示模型在葡语手写、场景文本与合成数据间的性能差距。研究发现,专门的多语言训练数据对葡萄牙语表现的影响远大于模型参数规模或输入分辨率,这一结论为低资源语言OCR研究指明了优化方向,重塑了资源分配策略。
实际应用
在实际应用层面,PorTEXTO所覆盖的手写文档和场景文本识别能力直接服务于葡萄牙语国家的数字化办公与信息管理需求。例如,机构内部的手写会议记录自动化转录、公共服务表格的电子化处理、以及街头标识与广告牌文本的实时提取均可借助基于PorTEXTO评估的模型得以实现。数据集强调的“当代相关性”确保模型能处理现代语境中的字体、书写风格与拍摄条件,从而推动从文化遗产保护到智能文档处理等诸多行业的本地化部署。
数据集最近研究
最新研究方向
随着多模态大语言模型与光学字符识别技术的深度融合,视觉文本提取研究正从通用场景向低资源语言及文化特异性数据倾斜。PorTEXTO作为首个聚焦当代欧洲葡萄牙语(pt-PT)视觉文本提取的基准数据集,其设计直击当前OCR与视觉语言模型在现实场景中的泛化瓶颈——模型在合成样本上表现优异,却在实际手写笔记与街景文本上出现显著性能滑坡。该数据集通过手写片段、全页文档、自然环境文本及合成图像四类子集,系统揭示了多语言专有数据对提升葡萄牙语文本识别精度的关键作用,而非单纯依赖模型参数规模或分辨率预算。这一前沿方向呼应了低资源语言智能化的紧迫需求,为葡萄牙语地区数字文化遗产保护、实时场景理解及多模态问答系统提供了富有挑战的评估基石,也推动了视觉文本提取领域从“技术通用”向“语言文化定制”的范式迁移。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

