
遇见数据集

softcatala/optimot-linguistic-data

收藏
Hugging Face2026-07-11 更新2026-07-22 收录
官方服务:

资源简介:

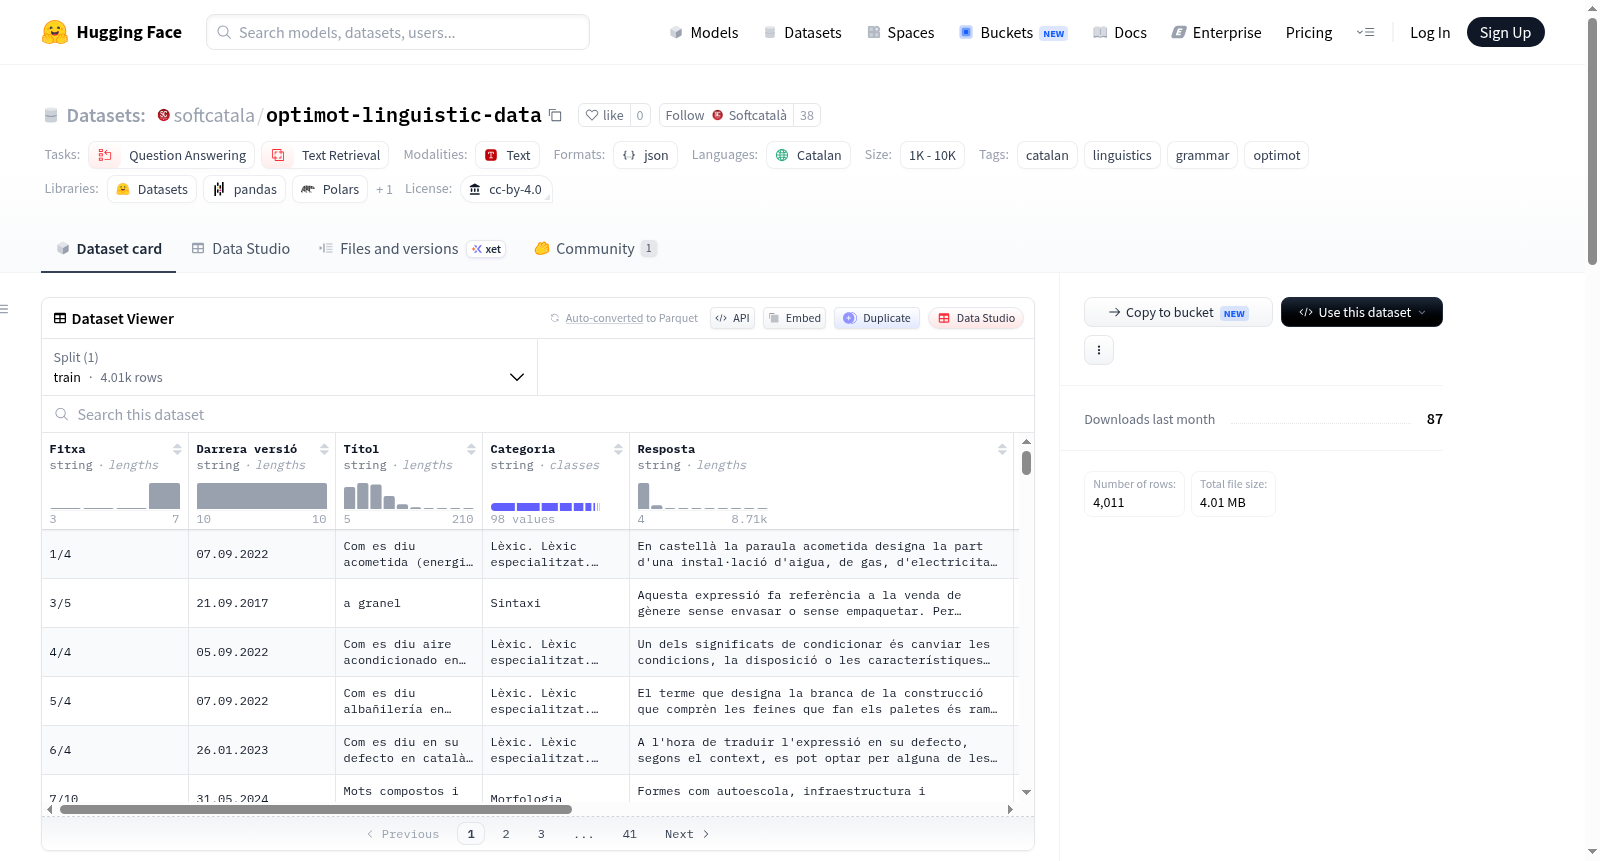
该数据集包含从加泰罗尼亚政府语言政策部门的公共Optimot语言咨询服务中提取的4,011个条目。每条记录都涉及一个加泰罗尼亚语问题或语言主题,并包括解释、来源元数据以及可用的直接来源URL。数据以JSON Lines格式提供,每个行包含字段如Fitxa(Optimot卡片标识符)、Darrera versió(最后更新日期)、Títol(条目标题)、Categoria(分类类别)、Resposta(答案或解释文本)、source(来源归属)、source_id(来源页面标识符)、source_url(直接URL)和download_date(数据集提取日期)。数据集适用于检索、搜索、加泰罗尼亚语语言辅助和语言资源实验,但不应作为独立基准使用,因为来源内容是公开的,可能已出现在模型预训练数据中。

This dataset contains 4,011 entries extracted from the public Optimot language advisory service of the Catalan Government's Language Policy Department. Each entry covers a Catalan language question or linguistic topic, and includes explanations, source metadata, and a direct source URL when available. The dataset is provided in JSON Lines format, with each line containing fields such as Fitxa (Optimot card identifier), Darrera versió (last update date), Títol (entry title), Categoria (category), Resposta (answer or explanatory text), source (source attribution), source_id (source page identifier), source_url (direct URL), and download_date (dataset extraction date). This dataset is suitable for retrieval, search, Catalan language assistance, and linguistic resource experiments, but should not be used as a standalone benchmark, as the source content is publicly available and may have been included in model pre-training data.
提供机构:
softcatala
搜集汇总
数据集介绍
softcatala/optimot-linguistic-data 数据集图片
构建方式
本数据集源自加泰罗尼亚语言政策部的公共语言咨询服务平台Optimot,由Softcatalà团队通过自动化脚本系统性地抓取与整理而成。数据以JSON Lines格式存储,每条记录对应一张Optimot卡片,涵盖问题编号、标题、分类、官方解答、来源归属及直接链接等字段。最终汇集4,011条高质量条目,确保了内容的权威性与实用性。
使用方法
使用时,可通过HuggingFace Datasets库轻松加载,仅需一条命令即可获取完整训练集。数据适用于问答系统、文本检索及加泰罗尼亚语语言资源研究等任务。引用时须注明来源为加泰罗尼亚政府语言政策部,并如实标注最后更新日期,禁止歪曲或误用原始信息。
背景与挑战
背景概述
Optimot Linguistic Data数据集由Softcatalà机构于2026年创建,旨在收录加泰罗尼亚语公共语言咨询服务平台Optimot中的高质量语言学条目。该数据集汇集了加泰罗尼亚自治区语言政策局提供的4,011条专家解答,覆盖语法规范、词汇用法及语言政策等核心问题。作为加泰罗尼亚语自然语言处理领域的重要资源,它首次以结构化形式呈现了该语言的官方语言学知识库,为问答系统、信息检索及语言资源实验提供了权威参考。其开源发布策略不仅促进了低资源语言的技术研究,更推动了加泰罗尼亚语在数字化语境中的传播与规范化应用。
当前挑战
该数据集面临的核心挑战在于所解决的领域问题与构建过程的双重复杂性。在领域层面,加泰罗尼亚语作为低资源语言,长期缺乏高质量、专家验证的语言学数据集,而Optimot Linguistic Data填补了针对语法规范与语言政策的知识空白,但其单一来源属性可能导致对特定术语或方言覆盖不足。在构建过程中,从非结构化公共服务平台中提取并结构化4,011条记录需处理版本迭代、分类歧义及URL失效等问题,同时需确保CC BY 4.0许可下的引用合规性,避免因数据公开性导致的基准评测泄露风险。
常用场景
经典使用场景
在加泰罗尼亚语自然语言处理领域,Optimot Linguistic Data数据集常被用于构建和评估语言咨询问答系统。该数据集包含4,011条来自官方语言咨询服务的问答对,覆盖词汇用法、语法规范、拼写规则等多维度语言学主题,为开发者提供了高质量的结构化语料。研究者通常将其作为检索增强生成(RAG)系统的基准数据,通过训练模型理解加泰罗尼亚语特有的语言现象,提升语言助手在回答语法与用法类问题时的准确性和可靠性。
解决学术问题
该数据集有效解决了加泰罗尼亚语语言资源匮乏导致的学术研究瓶颈。在计算语言学领域,地域小众语言的标准化问答数据集极为稀缺,而Optimot Linguistic Data填补了这一空白,使研究者能够系统性地探索面向规范性语言咨询的信息检索与问答技术。它推动了多语言自然语言处理中低资源语言模型的适配研究,并促进了对官方语言政策与公众语言使用之间互动关系的量化分析,为语言规划与教育领域的学术讨论提供了实证基础。
实际应用
在实际应用中,Optimot Linguistic Data支撑了加泰罗尼亚语智能语言助手与拼写检查工具的开发。开发者利用该数据集训练模型,使其能够准确解析用户提交的语言疑惑,并给出符合官方规范的解答。此外,该数据集被集成到公文写作辅助系统和在线翻译平台中,帮助非母语使用者或普通公众快速获取权威语法指引,显著提升了加泰罗尼亚语在数字场景下的可用性与规范性。
数据集最近研究
最新研究方向
在加泰罗尼亚语言资源数字化与低资源语言智能处理的前沿探索中,该数据集聚焦于语言学知识的结构化检索与问答系统构建,回应了近年来加泰罗尼亚语在自然语言处理领域受关注度攀升的趋势。通过整合官方语言咨询服务的专家回答与元数据,它推动了语法、用词规范等细粒度语言知识的可计算化,为构建面向加泰罗尼亚语的智能语言助手与教育工具奠定了数据基础。这一资源契合了欧盟推动区域语言数字化保护的宏观政策导向,尤其在低资源语言信息检索与生成式模型微调中展现出独特价值,有助于缓解主流语料库中加泰罗尼亚语覆盖不足的瓶颈,并为跨语种语言学迁移学习提供了可复用的结构化参考标准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

