
meituan-longcat/LARYBench
收藏官方服务:
资源简介:
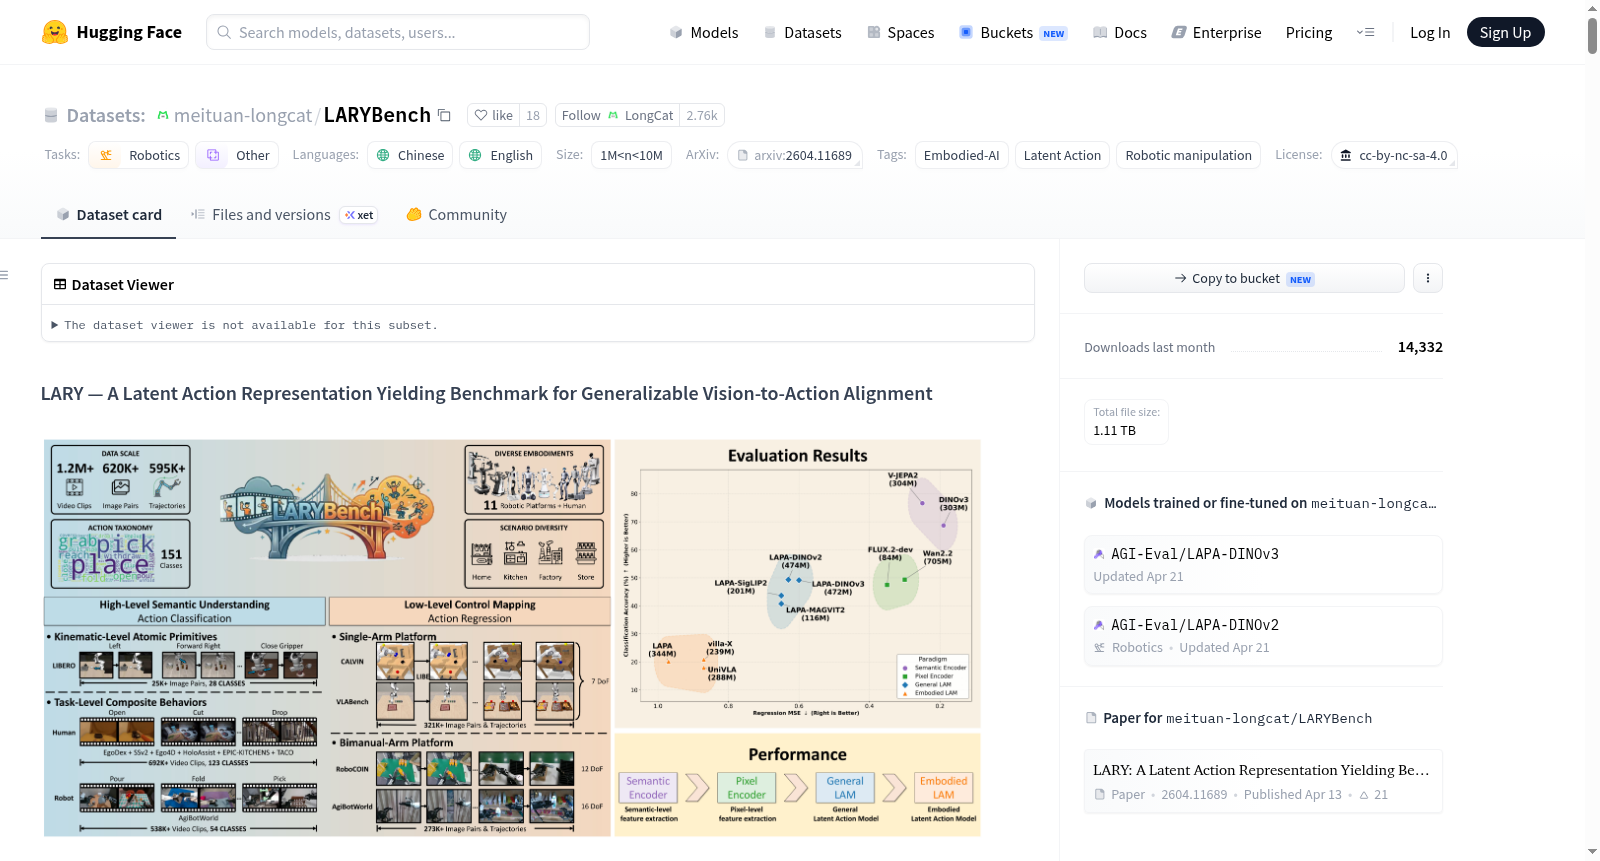
LARY(Latent Action Representation Yielding)是一个用于评估潜在动作表示的统一框架。该数据集包含超过一百万视频(1,000小时)、62万图像对和59.5万运动轨迹,涵盖151个动作类别和11种机器人实体。LARY提供了三个互补的评估流程:提取潜在动作、分类(动作语义识别)和回归(机器人动作解码)。数据集支持中英文,并包含多样化的环境和实体。
LARY (Latent Action Representation Yielding) is a unified framework for evaluating latent action representations. The dataset comprises over one million videos (1,000 hours), 620K image pairs, and 595K motion trajectories across 151 action categories and 11 robotic embodiments. LARY provides three complementary evaluation pipelines: extracting latent actions, classification (action-type recognition), and regression (action regression for robotic control). The dataset supports both Chinese and English and includes diverse environments and embodiments.
提供机构:
meituan-longcat搜集汇总
数据集介绍
构建方式
LARYBench的构建依托于一套自动化的数据处理引擎,通过重新分割与标注大规模语料库,整合了逾百万段视频(总计1000小时),涵盖151个动作类别,同时包含62万对图像对和59.5万条运动轨迹。这些数据源自人类与机器人在仿真及真实环境中的第一人称与第三人称视角,跨越11种机器人形态,从而实现了对隐式动作表示在高层语义与底层物理控制两个维度上的全面评估。
特点
该数据集的核心在于其双轨评估机制:一方面通过分类任务探测隐式动作表示在语义层面(做什么)的编码能力,另一方面通过回归任务评估其在物理机器人动作解码(怎么做)上的表现。这种设计使得LARYBench成为首个将隐式动作表示的评价从下游策略性能中解耦出来的标准化基准。此外,数据集中包含的多样化机器人与环境配置,为研究视觉基础模型与专有机器人动作表示之间的对齐提供了丰富的测试场景。
使用方法
LARYBench提供了统一的三阶段评估管线。用户首先通过‘get_latent_action’模块从视频或图像对中提取隐式动作特征,随后利用分类管线训练轻量级MLP分类器以评估语义编码能力,或者通过回归管线利用MLPResNet或DiT扩散解码器预测物理动作序列。所有步骤均通过命令行接口完成,支持分布式提取以处理大规模数据,且新增模型只需修改单一文件即可集成,极大降低了使用门槛。
背景与挑战
背景概述
LARYBench(Latent Action Representation Yielding Benchmark)诞生于美团LongCat团队,于2026年4月正式发布,旨在系统评估潜在动作表示在具身智能领域的泛化能力。随着视觉-语言-动作(VLA)模型的兴起,显式动作数据的匮乏成为制约其发展的瓶颈,而大规模人类动作视频虽蕴含丰富的控制信息,却因缺乏统一的动作表示框架而难以被有效利用。LARYBench首次将潜在动作表示的评价从下游策略性能中解耦出来,构建了一个包含逾百万视频(累计1000小时)、62万图像对及59.5万运动轨迹的庞大数据引擎,覆盖151个动作类别与11种机器人形态,横跨人类与机器人视角、仿真与现实世界。该基准的核心研究问题在于:视觉基础模型能否在无显式动作监督的条件下,从观测中提取出足以支撑高语义动作识别与低层物理控制的潜在动作表示。研究表明,通用视觉表征天然编码了与控制相关的动作知识,且基于潜在特征空间的对齐方式优于像素级重建,这为构建可泛化的具身智能系统提供了新的理论路径与评估范式。
当前挑战
LARYBench所解决的核心领域挑战在于:如何将大规模、无标注的人类动作视频转化为可迁移、与具身结构无关的潜在动作表示,从而打通视觉观测与物理控制之间的语义鸿沟。现有VLA模型多依赖稀缺的机器人遥操作数据,难以泛化至多样化的环境与形态,而通用视觉模型虽展现了潜在的泛化能力,但其内部学习到的动作知识尚未被系统验证。在构建过程中,团队面临多重挑战:第一,数据异质性显著,需整合来自不同源(如EPIC-KITCHENS、EgoDex、LIBERO等)的视频、图像对与轨迹数据,并实现统一的语义标注与动作分割;第二,潜在动作表示的质量评估缺乏标准化工具,传统方法常将表示评测与下游策略性能捆绑,导致混淆因素过多;第三,跨形态对齐困难,不同机器人执行器与人类手部的动作空间结构差异巨大,需设计不依赖本体感受的通用表示提取与评测管线,以确保基准的公平性与实用性。
常用场景
经典使用场景
在具身智能与机器人操作领域,LARYBench作为首个系统评估潜在动作表征(Latent Action Representation)的基准数据集,其核心使用场景在于衡量视觉模型对动作语义与物理控制的编码能力。通过融合超过一百万段视频、六十二万对图像以及五十九万条运动轨迹,该数据集构建了涵盖分类与回归的双轨评估管线:分类任务探查模型对高层动作类型("做什么")的识别精度,回归任务则度量从潜空间解码出机器人底层控制信号("怎么做")的准确性。这一设计使得研究者能够独立于下游策略性能,直接度量表征质量本身。
衍生相关工作
LARYBench的发布催生了多项具有影响力的衍生工作。其提供的标准化评估框架促使研究者重新审视视觉表征在机器人学习中的角色,推动了诸如LAPA-DINOv3、LAPA-DINOv2系列模型的改进与开源。此外,数据集中揭示的"通用视觉模型优于专用具身模型"这一反直觉结论,启发了一系列探索视觉预训练与动作表征之间内在关联的研究,间接促进了视觉基础模型在行为克隆、模仿学习等领域的广泛适配。数据集所支持的分类与回归双评估范式,也被后续的机器人学习基准所采纳和延伸,成为衡量表征质量事实上的行业标准之一。
数据集最近研究
最新研究方向
LARYBench数据集聚焦于具身智能领域中潜在动作表征的统一评估框架构建,旨在解决视觉-语言-动作模型因显式动作数据匮乏而面临的扩展瓶颈。当前前沿研究方向围绕两大核心洞察展开:其一,无需动作监督的通用视觉基础模型在提取动作语义方面竟优于专门设计的具身潜在动作模型,揭示了大规模视觉预训练中隐式编码的动作相关知识;其二,基于潜在语义的特征空间相较于像素级空间与物理动作空间呈现出更本质的对齐优势,表明从视觉到动作的转化中语义抽象路径优于像素重建路径。该基准通过覆盖151种动作类别、超百万视频及62万图像对的庞大规模数据集,系统评估了高维语义识别与低维物理控制的双重维度,为新一代视觉-语言-动作系统的发展提供了重要的方法论启示与标准化评测平台。
以上内容由遇见数据集搜集并总结生成


