
遇见数据集

ales_razanau_output

收藏
Hugging Face2026-06-01 更新2026-06-02 收录
官方服务:

资源简介:

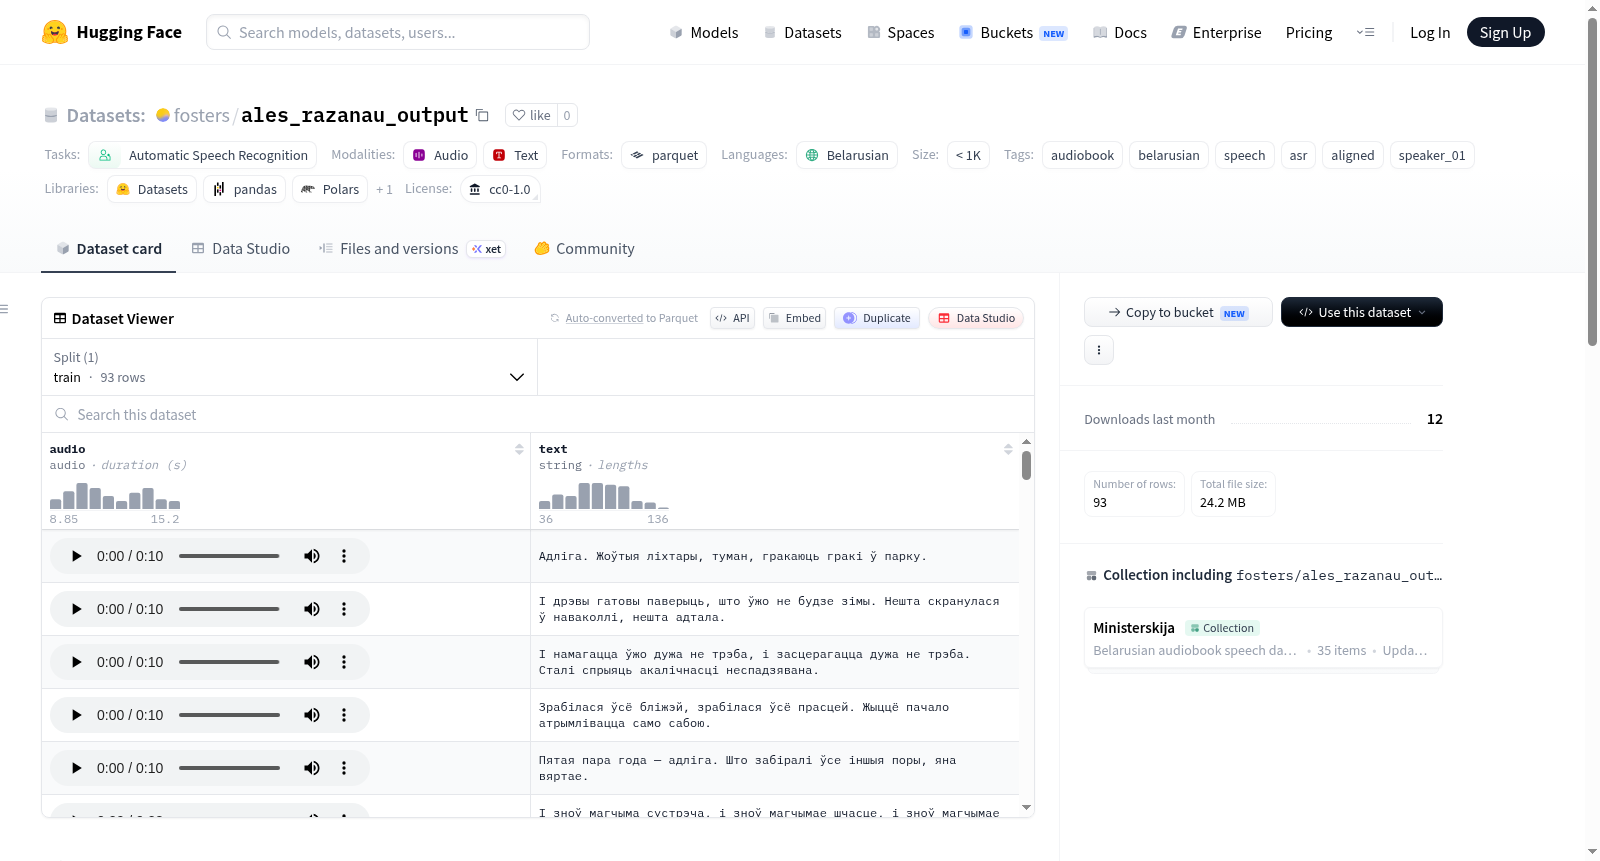
“Зборнік”数据集是Ministerskija集合的一部分,专门用于白俄罗斯语自动语音识别任务。该数据集由作者Алесь Разанаў创建,包含对齐的白俄罗斯语有声读物音频录音及其转录文本。数据集规模为1K到10K级别,具体包含106个数据行(其中93行在HuggingFace上发布),音频总时长约为21分钟。每个数据样本包含三个字段:audio(约15秒的音频片段)、text(对应的转录文本)和chunk_uid(片段的唯一标识符)。数据通过处理流程生成:原始有声读物被分割成短音频片段,然后使用Gemini和两个独立的自动语音识别系统与转录文本进行对齐,确保对齐置信度不低于0.95。该数据集适用于训练或评估白俄罗斯语语音识别模型,尤其针对有声读物领域的应用。

The "Зборнік" dataset is part of the Ministerskija Collection, specifically dedicated to Belarusian automatic speech recognition tasks. Created by author Ales Razanau, this dataset includes aligned Belarusian audiobook audio recordings and their corresponding transcriptions. The dataset has a scale ranging from 1K to 10K, containing 106 data entries in total, 93 of which are released on Hugging Face, with a total audio duration of approximately 21 minutes. Each data sample comprises three fields: `audio` (a ~15-second audio clip), `text` (the corresponding transcription text), and `chunk_uid` (the unique identifier of the clip). The dataset is generated through a processing pipeline: original audiobooks are split into short audio segments, then aligned with their transcriptions using Gemini and two independent automatic speech recognition systems, with an alignment confidence score of no less than 0.95. This dataset is applicable for training or evaluating Belarusian speech recognition models, especially for audiobook-domain applications.

创建时间:
2026-05-31
原始信息汇总

数据集概述:Зборнік — Алесь Разанаў

  • 语言:白俄罗斯语(Belarusian)
  • 许可证:CC0-1.0(公有领域)
  • 任务类别:自动语音识别(ASR)
  • 标签:audiobook, belarusian, speech, asr, aligned, speaker_01
  • 数据集大小:1,000条至10,000条之间

数据集详情

  • 发布行数(HF):93行
  • 数据库总计:106行
  • 音频总时长:0小时21分钟
  • 置信度阈值:≥ 0.95

数据结构

每一行包含三个字段:

  • audio:音频片段(约15秒)
  • text:转录文本(由Gemini与ASR对齐生成)
  • chunk_uid:片段的唯一标识符

数据处理

音频书籍被分割为短片段,并通过Gemini和两个独立的ASR系统进行转录对齐。对齐置信度≥0.95。

说话人信息

说话人识别由WavLM-Base+模型确定(余弦相似度,阈值=0.82)。

所属合集

该数据集属于 Ministerskija 收藏集,该收藏集包含已对齐的白俄罗斯语音频书转录数据。
搜集汇总
数据集介绍
ales_razanau_output 数据集图片
构建方式
该数据集源自白俄罗斯诗人阿列斯·拉扎纳夫(Алесь Разанаў)的音频书籍,是Ministerskija语料库合集的一部分。构建过程首先将原始音频书籍切割为约15秒的短片段,随后利用Gemini模型与两套独立的自动语音识别(ASR)系统进行联合对齐,生成对应的文本转录。每个片段均附有对齐置信度得分,并仅保留置信度不低于0.95的高质量条目,最终汇聚为包含93条已发布样本的紧凑型资源。
使用方法
数据集以HuggingFace Datasets格式发布,每条记录包含audio字段(音频片段)、text字段(转录文本)及chunk_uid字段(唯一标识符),可直接通过datasets库加载。适用于白俄罗斯语自动语音识别(ASR)模型的微调、说话人验证或对齐算法评估。用户可利用提供的speaker_01聚类信息进行多说话人分离实验,或结合置信度筛选策略进一步优化训练数据质量。数据集遵循CC0-1.0许可,可自由用于学术与商业场景。
背景与挑战
背景概述
白俄罗斯语作为东斯拉夫语支的重要语言,其语音资源的匮乏长期制约着自动语音识别(ASR)技术的发展。在此背景下,Ales Razanau数据集于2024年由fosters机构创建,为白俄罗斯语语音研究提供了关键资源。该数据集精选自白俄罗斯诗人Ales Razanau的音频书籍,包含106条经过精准对齐的语音片段,总时长约21分钟,由单个说话者(speaker_01)录制。其核心研究问题在于构建高置信度(≥0.95)的语音-文本对齐数据,以支持白俄罗斯语ASR模型的训练与评估。作为Ministerskija语料库集合的一部分,该数据集通过Gemini模型与双ASR系统的协同校准,有效提升了语音识别的对齐精度,为低资源语言语音处理领域树立了范本,对推动东斯拉夫语支的数字语言保护与技术应用具有开创性意义。
当前挑战
该数据集着力应对白俄罗斯语ASR领域的两大核心挑战。在领域问题层面,低资源语言普遍面临的标注数据稀缺问题尤为突出,白俄罗斯语缺乏大规模、高质量的对齐语音数据集,限制了端到端ASR模型的泛化能力;同时,语音文本对齐任务中因语言独特音系与说话人特征引发的误差累积,使得高精度转录面临困难。在构建过程中,研究者需克服音频书籍切割时保持语义连贯性的难题,并借助Gemini与双ASR系统的多模型融合策略,以0.95的置信度阈值过滤低质量对齐,剔除了约12%的初始候选数据(仅保留93条发布条目)。此外,单说话人场景下的声学特征单一性(平均相似度0.878)也增加了构建数据多样性挑战,迫使后续研究依赖邻近数据集(如raisa_baravikova_vasmiradkou_i_output)进行补充与泛化评估。
常用场景
经典使用场景
在低资源语言语音识别研究领域中,白俄罗斯语因其数据匮乏而长期处于学术边缘地带。ales_razanau_output数据集专为自动语音识别(ASR)任务而构建,提供了来自白俄罗斯语有声读物的精准对齐语音片段与文本转录,每段音频约15秒,对齐置信度高达0.95以上。该数据集最经典的使用场景是训练和评估低资源语言的端到端ASR模型,尤其适用于说话人识别与语音文本对齐技术的联合优化,填补了白俄罗斯语语音资源的空白。
解决学术问题
该数据集有效解决了白俄罗斯语在语音识别领域缺乏高质量对齐数据的学术困境。传统ASR研究往往聚焦于英语等主流语言,而白俄罗斯语因资源稀缺难以开展系统性实验。ales_razanau_output通过精密的后处理流程——结合Gemini大语言模型与双ASR系统的交叉验证,实现了噪声环境下语音与文本的稳健对齐,为低资源语言语音识别的数据构建方法提供了可靠范本,推动了多语言语音技术的公平性与多样性发展。
实际应用
在现实应用中,该数据集可赋能白俄罗斯语智能语音助手、有声读物自动字幕生成和语音搜索等场景。借助该数据集训练的ASR模型,能够准确转录白俄罗斯语文学作品的朗读音频,服务于文化遗产数字化保护项目,例如将珍贵的有声书籍转化为可检索的文本档案,助力少数民族语言在数字时代的传承与传播。此外,该数据也适用于教育领域,为白俄罗斯语学习者提供语音与文本同步的辅助材料。
数据集最近研究
最新研究方向
在当前低资源语言语音识别研究蓬勃发展的背景下,白俄罗斯语作为斯拉夫语系中的边缘语言,其语音数据的稀缺性一直是制约相关技术突破的关键瓶颈。该数据集聚焦于诗人阿列西·拉扎纳夫的有声读物,通过Gemini大模型与双ASR系统的协同对齐策略,生成高置信度(≥0.95)的精细对齐语料,为白俄罗斯语自动语音识别提供了高质量、短时长的音频-文本配对资源。这一前沿研究方向巧妙融合了生成式AI与传统语音技术的优势,不仅有效解决了小语种数据标注成本高昂的难题,也为探索多模型联合优化、低资源场景下的跨说话人泛化能力树立了典范。其影响在于,该数据集作为Ministerskija语料库的重要组成部分,为构建白俄罗斯语语音助手、数字人文应用及语言保护工作注入了关键数据动力,推动了少数民族语言在AI时代的数字化生存。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

