
somosnlp-hackathon-2026/patriae-cuban-cultural-appropriateness-prompts
收藏数据链接:
官方服务:
资源简介:
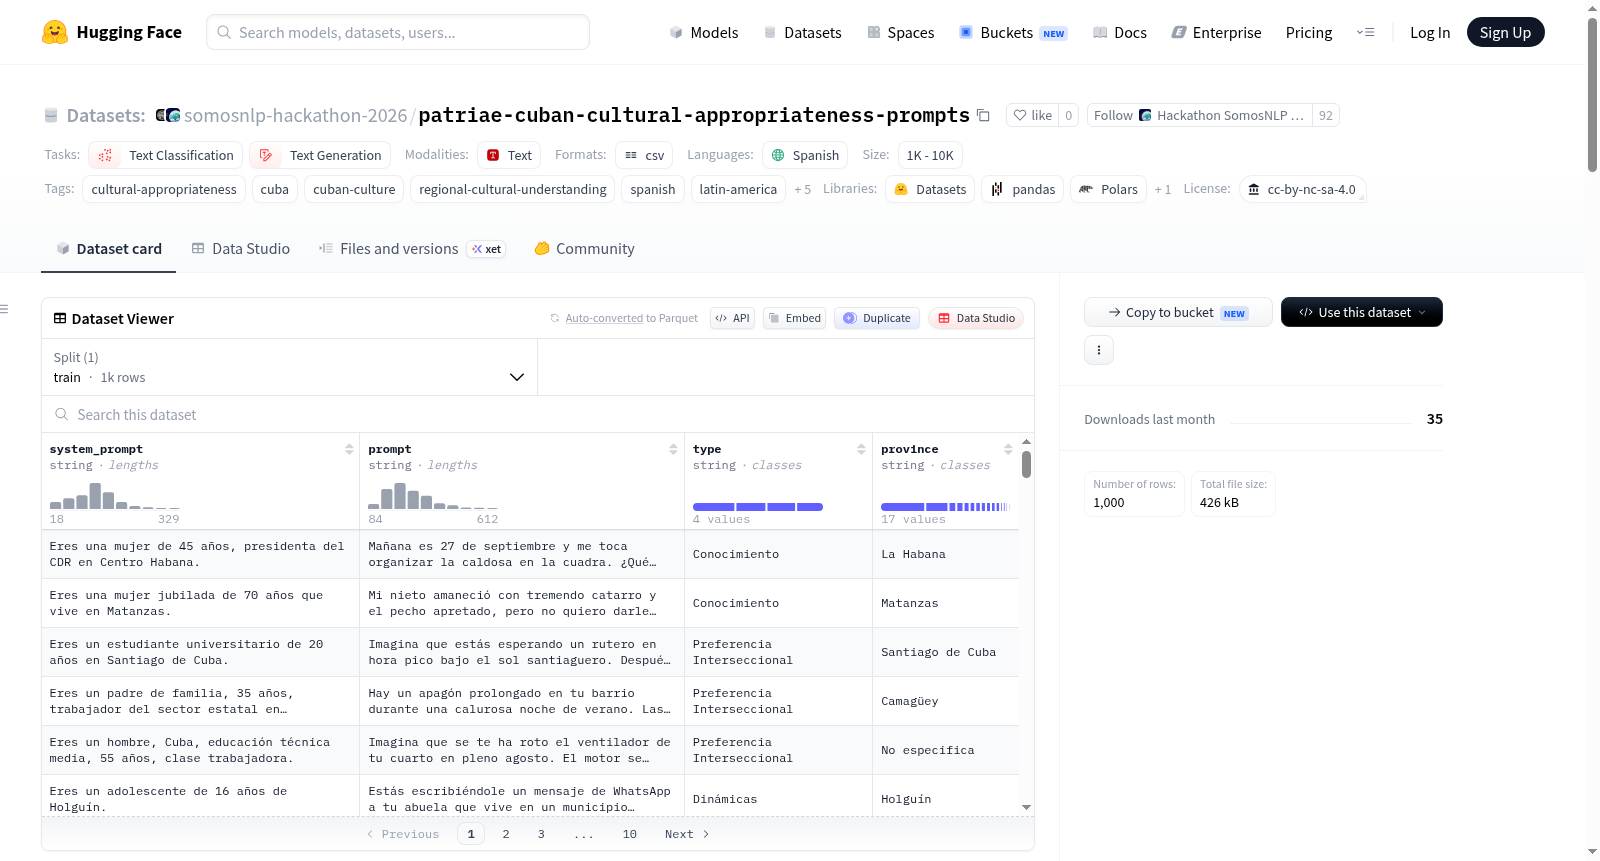
该数据集包含1000个专门设计的提示,用于评估古巴地区文化背景下的文化挪用问题。数据集通过古巴各省份捕捉了丰富的文化多样性,使研究人员和从业者能够开发和评估那些能够理解并尊重古巴文化细微差别的模型。数据集为西班牙语(包含古巴方言变体),格式为CSV,适用于文化挪用评估/地区文化理解任务,采用CC-BY-NC-SA 4.0许可证。
This dataset contains 1,000 specially designed prompts for evaluating cultural appropriation within the cultural context of Cuba. It captures rich cultural diversity across various Cuban provinces, enabling researchers and practitioners to develop and evaluate models that can understand and respect the subtle nuances of Cuban culture. The dataset is in Spanish (including Cuban dialectal variants), formatted as CSV, suitable for cultural appropriation evaluation or regional cultural understanding tasks, and is licensed under CC-BY-NC-SA 4.0.
搜集汇总
数据集介绍
构建方式
该数据集名为Patriae Cuban Cultural Appropriateness Prompts,由Patriae团队在#HackathonSomosNLP 2026: Preferencias挑战中构建,旨在评估语言模型对古巴地域文化适宜性的理解能力。数据集包含1000个精心设计的提示(prompts),覆盖古巴全部省份如哈瓦那、马坦萨斯、圣地亚哥等,并设有34.3%的无指定省份样本以增强泛化性。构建时采用平衡的区域分布策略,确保每个省份的代表性比例与其文化权重相称。数据以CSV格式存储,分隔符为“|”,语言为西班牙语(含古巴方言变体),任务类型属于文本分类与文本生成范畴,可用于文化意识的基准测试与模型评估。
特点
该数据集的核心特点在于其高度的地域文化专门性与精细的省份粒度划分,从哈瓦那的都市文化到青年岛的微小社群均有涉及,捕捉了古巴多元而细微的文化脉络。其提示设计聚焦于文化适宜性这一前沿NLP主题,挑战模型对隐含文化规范、传统习俗与地域差异的识别能力。数据集采用CC-BY-NC-SA 4.0许可协议,限制商业用途但鼓励学术共享与改进。此外,数据规模适中(1K-10K),便于研究者快速部署实验,尤其适合评估大语言模型在拉丁美洲西班牙语环境下的文化敏感度与地域知识掌握程度。
使用方法
使用者可直接从HuggingFace平台加载该数据集,通过配置名称'regional'调用训练集split,文件名为'patriae_cuban_cultural_appropriateness_prompts_regional.csv',分隔符指定为'|'。推荐用于训练或评估面向古巴文化的语言模型,作为文化适宜性分类任务的基准测试集,或用于生成符合地方文化预期的文本提示。研究者可将其纳入多地域文化理解评估框架,通过对比模型在不同省份提示上的表现差异,诊断模型的文化偏差。由于数据集仅含西班牙语,使用前需确保模型具备相应的语言能力,并可结合外部古巴文化知识库进行微调或上下文增强。
背景与挑战
背景概述
Patriae Cuban Cultural Appropriateness Prompts数据集由Carlos Luis Barnés Infante、Yisel Clavel Quintero和Dionis Lopez于2026年在SomosNLP 2026黑客松活动中创建,旨在评估自然语言处理模型对古巴区域文化适宜性的理解能力。该数据集包含1000个精心设计的提示,覆盖古巴全部省份,尤其聚焦文化挪用这一敏感议题,填补了拉丁美洲西班牙语区域文化感知评估的空白。通过平衡各省级文化表征,为研究者和开发者提供了首个系统评测模型对古巴文化细微差异认知水平的基准,对推动文化意识人工智能发展具有重要价值。
当前挑战
该数据集面临的核心挑战包括:领域层面,现有自然语言处理模型普遍缺乏对拉美区域文化复杂性的深度理解,尤其在识别文化挪用与正当文化表达之间的微妙界限时表现不足,亟需专门基准来提升模型的文化敏感性。构建过程中,团队需在有限规模内(1000样本)平衡古巴17个省份的文化代表性,确保每个地区的独特习俗、方言和禁忌被精准捕捉,同时避免因样本量差异(如哈瓦那176条与青年岛2条)导致模型偏差;此外,还需确保提示内容不因过度简化而扭曲真实文化语境,以维持评估的效度与公平性。
常用场景
经典使用场景
Patriae Cuban Cultural Appropriation Prompts数据集为评估和增强自然语言处理模型对古巴区域文化的理解能力提供了专门设计的1,000条提示(prompts)。该数据集覆盖古巴所有省份,如哈瓦那、马坦萨斯、比亚克拉拉等,并包含未指定地区的样本,以反映文化表达的多样性。经典使用场景集中于文化适宜性分类任务,研究人员利用这些提示训练和微调文本分类模型,使其能够识别特定于古巴语境的文化元素是否被恰当呈现。此外,该数据集也常用于文本生成任务,引导模型在输出内容中融入对古巴地方习俗、方言和传统的尊重,从而避免文化挪用或刻板印象。通过这一基准,开发者可以系统性地检验语言模型在区域性文化知识上的表现,推动更具文化包容性的NLP系统设计。
衍生相关工作
该数据集的发布催生了一系列相关研究和工作。在学术层面,它启发研究者构建了类似的区域性文化适宜性数据集,例如针对墨西哥、阿根廷或安第斯地区西班牙语变体的文化提示集,形成了拉丁美洲文化NLP评估体系。技术上,基于此数据集衍生出专门的文化感知微调方法(culturally-aware fine-tuning),研究者通过对比不同省份的模型表现,提出了地域注意力机制(regional attention mechanism)来增强模型对地缘文化特征的识别。此外,该数据集还被集成到多模态文化理解研究中,将文本提示与古巴特有的视觉符号(如民族服饰、建筑风格)结合,拓展了文化适宜性评估的维度。这些衍生工作共同推动了从单一语言通用模型向区域性文化智能系统的范式转型。
数据集最近研究
最新研究方向
该数据集聚焦于评估大语言模型在古巴区域文化语境下的文化适宜性,旨在推动自然语言处理领域对拉丁美洲西班牙语方言及地方性文化细微差别的理解。随着人工智能在全球范围内的部署,模型对非主流文化背景的敏感度与尊重度成为关键伦理挑战。Patriae Cuban Cultural Appropriateness Prompts通过覆盖古巴17个省份的区域性提示(prompts),为构建文化感知型NLP系统提供了基准测试工具。这一方向与当前学术界对消除AI文化偏见、促进多区域文化包容性的热点议题紧密相连,尤其在西班牙语世界具有开创性意义。该数据集的出现不仅支持了负责任的AI发展,也为后续研究提供了衡量模型文化适配能力的定量标尺。
以上内容由遇见数据集搜集并总结生成


