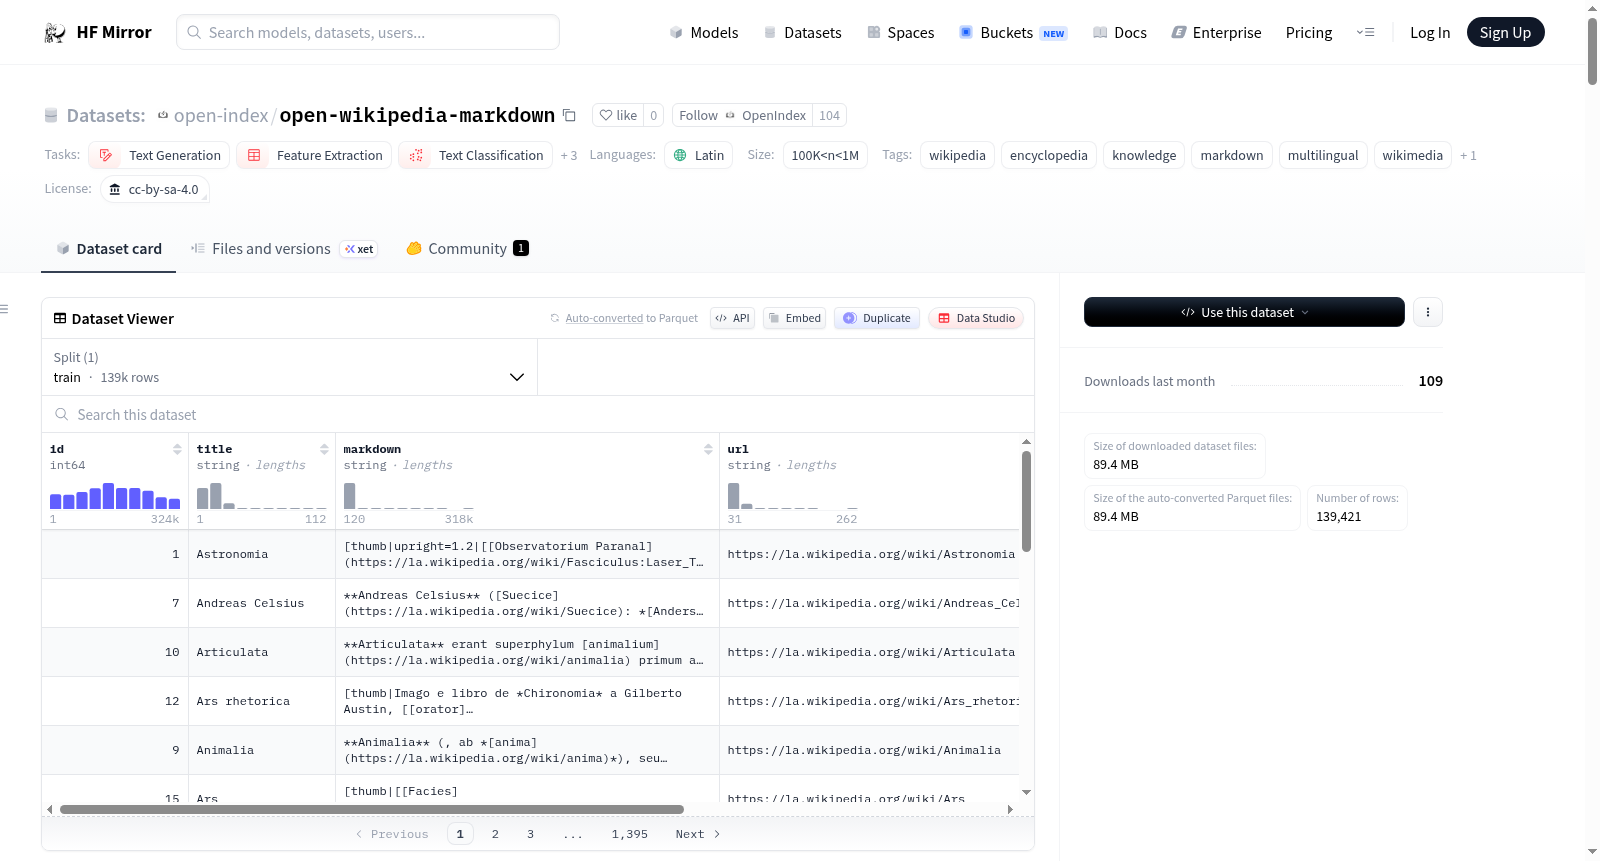
open-index/open-wikipedia-markdown
收藏资源简介:
这是一个多语言的维基百科数据集,采用Markdown格式,涵盖了大量语言和方言。数据集适用于多种自然语言处理任务,包括文本生成、特征提取、文本分类、问答、摘要和翻译。数据集遵循知识共享署名-相同方式共享4.0许可协议(CC-BY-SA-4.0),属于开放数据,旨在促进知识的共享和传播。数据规模介于1000万到1亿条记录之间,按语言分类存储为parquet文件格式。
This is a multilingual Wikipedia dataset in Markdown format, covering a wide range of languages and dialects. The dataset is suitable for various natural language processing tasks, including text generation, feature extraction, text classification, question answering, summarization, and translation. It is licensed under the Creative Commons Attribution-ShareAlike 4.0 license (CC-BY-SA-4.0), intended as open data to promote the sharing and dissemination of knowledge. The dataset size ranges between 10 million and 100 million records, organized by language and stored in parquet file format.
数据集:open-index/open-wikipedia-
- 链接:https://hf-mirror.com/datasets/open-index/open-wikipedia-markdown
- 任务:文本生成、特征提取、文本分类等
- 语言:367种语言(如英语、德语、法语、中文、日语等)
- 大小:10M < 样本数 < 100M
- 标签:wikipedia, encyclopedia, knowledge, markdown, multilingual, wikimedia
- 许可证:cc-by-sa-4.0
数据集描述
该数据集包含来自维基百科所有语言版本的每篇文章,已从原始的MediaWiki标记转换为干净、可读的 Markdown 格式。保留了标题、粗体、斜体、代码块和内部链接作为正确的Markdown语法,同时去除了模板、信息框、参考文献、表格、分类等噪音。
数据规模
- 目前包含 6590万篇文章,覆盖 367种语言。
- 最大语言:英语 (en) 约 710万篇文章,15个分片。
- 其他大语言包括:德语 (de) 310万、法语 (fr) 270万、瑞典语 (sv) 260万、荷兰语 (nl) 220万、俄语 (ru) 210万、西班牙语 (es) 200万、意大利语 (it) 190万等。
- 部分小语言(如 aa, hz, kr, lrc, na)文章数为0。
数据格式
-
数据存储为分片的 Apache Parquet 文件,使用 Zstandard 压缩。
-
每个语言一个独立目录,每个分片最多包含 50万篇文章。
-
目录结构示例:
data/ en/en-00000.parquet (英语,分片0) en/en-00001.parquet (英语,分片1) ... de/de-00000.parquet (德语) fr/fr-00000.parquet (法语) ...
数据模式
| 列名 | 类型 | 描述 |
|---|---|---|
id |
int64 |
维基百科页面ID(每种语言内唯一) |
title |
string |
文章标题(如维基百科所示) |
markdown |
string |
完整的Markdown格式文章内容 |
length |
int64 |
Markdown文本的字符长度 |
url |
string |
维基百科文章的完整URL |
lang |
string |
ISO 639语言代码 |
数据来源
内容来源于官方的 Wikimedia 数据库转储文件(dump),对每种语言的完整XML导出进行流式处理、解析并逐篇文章转换。
使用方法
-
使用
datasets库加载: python from datasets import load_dataset ds = load_dataset("open-index/open-wikipedia-markdown", "en") -
使用 DuckDB 直接查询: sql SELECT lang, COUNT() as articles FROM read_parquet(hf://datasets/open-index/open-wikipedia-markdown/data//*.parquet) GROUP BY lang ORDER BY articles DESC;
-
使用
huggingface_hub下载: python from huggingface_hub import snapshot_download snapshot_download("open-index/open-wikipedia-markdown", repo_type="dataset", local_dir="./wiki-md/", allow_patterns="data/en/*") -
使用 Polars 读取: python import polars as pl df = pl.read_parquet("data/en/*.parquet")
额外信息
- 数据集包含一个
stats.csv文件,可查询每种语言的统计数据(文章数、分片数、文件大小、处理时长等)。 - 除了 Markdown 变体外,还有纯文本变体(所有格式被移除)和原始 MediaWiki 标记变体。