
overthelex/pl-court-decisions
收藏官方服务:
资源简介:
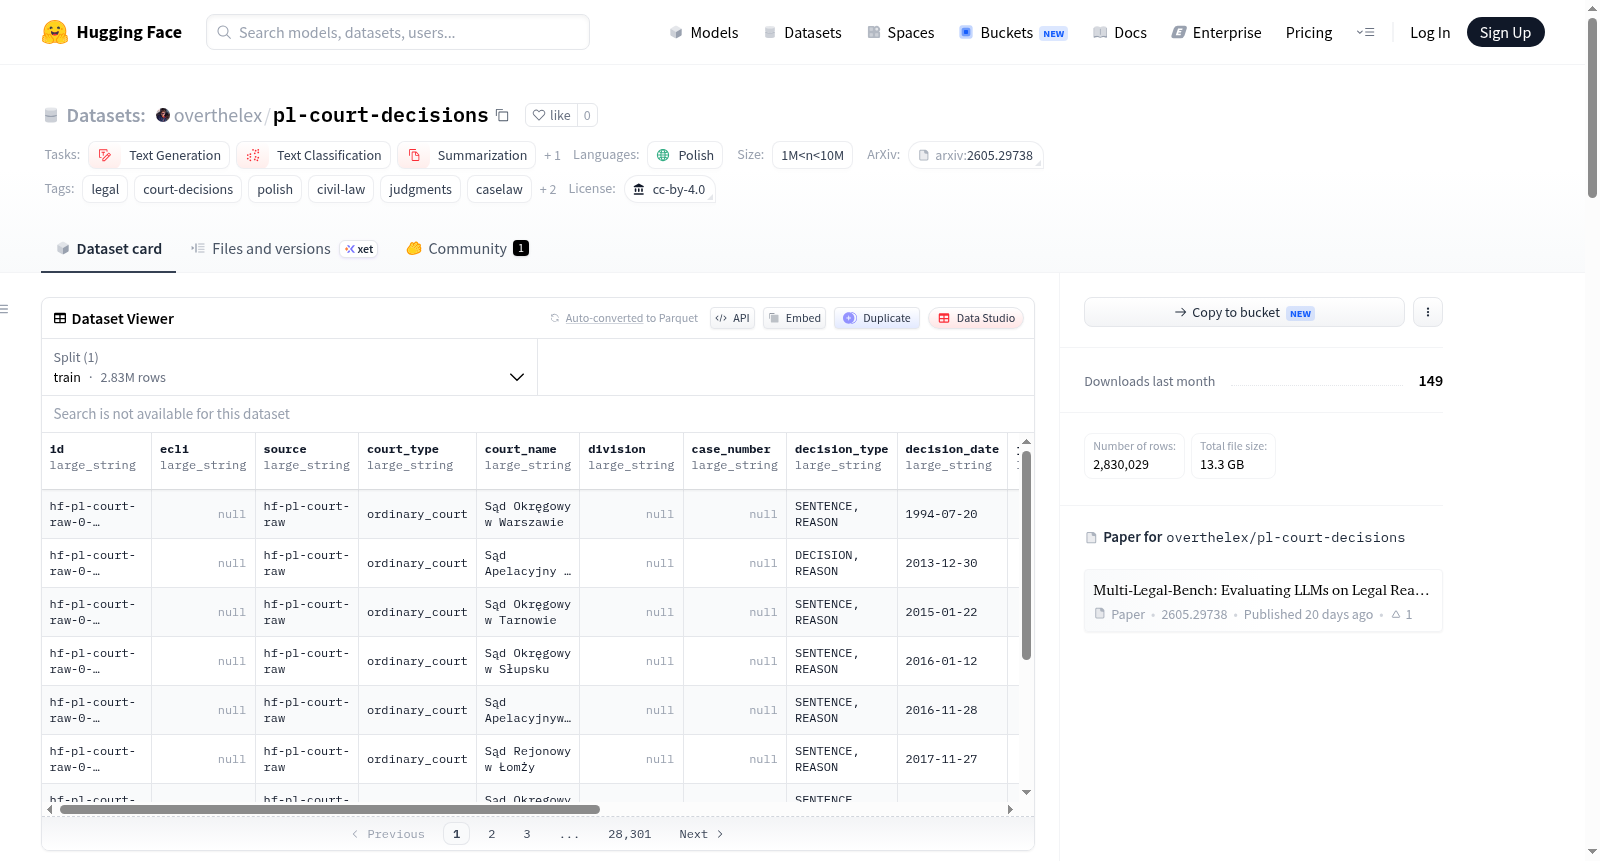
最大的波兰法院判决开放数据集:包含**2,830,029份判决**,涵盖所有法院层级的全文。
The largest open dataset of Polish court decisions: **2,830,029 decisions** with full texts across all court levels.
提供机构:
overthelex搜集汇总
数据集介绍
构建方式
该数据集整合了波兰司法体系中三大核心判例来源:通过SAOS API获取的最高法院、宪法法庭及国家上诉委员会裁决共492,731份,并与JuDDGES项目中收录的437,446份普通法院判例及1,899,852份行政法院判例进行合并。构建过程中实施了严格的数据清洗流程,包括去除12,213条SAOS内部重复记录(保留文本最长者)、剔除27,473条空文本及153条字符数不足100的微短文本,最终形成涵盖2000年至2026年期间、总计2,830,029份判决全文的高质量数据集。
特点
该数据集的核心优势在于其全面性与独特性,不仅囊括了普通法院与行政法院的判例,更独家收录了此前任何公开HuggingFace数据集(如JuDDGES、Multi_Legal_Pile、LEXTREME)均缺失的最高法院、宪法法庭及国家上诉委员会的493K份裁决。数据结构方面,每条记录包含id、欧洲判例标识符(ECLI)、来源标识、法院类型、案号、判决类型、日期、法官、关键词、法律依据及全文文本等14个字段,并支持流式加载,便于大规模法律自然语言处理研究。
使用方法
该数据集通过HuggingFace Datasets库以Parquet格式封装,用户可直接调用`load_dataset`方法加载训练集,支持流式(streaming)模式以高效处理超过280万条记录。开发者可通过`court_type`、`source`等字段筛选特定法院层级或来源的判例,利用`full_text`字段进行文本生成、文本分类、摘要抽取及特征提取等任务。数据集已获CC BY 4.0许可,可用于学术研究及商业应用,其引入论文详细介绍了在跨法域法律推理基准测试中的应用方法。
背景与挑战
背景概述
在法律自然语言处理领域,大规模、高质量且覆盖完整司法体系的判例数据集始终是推动模型发展的基石。2026年,由Volodymyr Ovcharov等研究者构建的Polish Court Decisions数据集正式发布,该数据集汇集了波兰各级法院(包括普通法院、行政法院、最高法院、宪法法庭及国家上诉委员会)自2000年至2026年间共计2,830,029份判决全文,其规模较此前HuggingFace上最大的波兰判例数据集(如JuDDGES)扩充逾26%,新增的493,732份最高法院等机构判决数据填补了现有资源的关键空白。该数据集的出现,为法律文本生成、分类、摘要及特征提取等任务提供了前所未有的数据基础,显著推动了多语言法律推理评估基准(Multi-Legal-Bench)的发展。
当前挑战
该数据集所应对的核心领域挑战在于,现有公开的波兰法律判例数据存在严重的机构覆盖缺失,尤其是最高法院和宪法法庭的判决长期缺乏系统整理,阻碍了法律推理模型的全面评估。在构建过程中,挑战尤为突出:首先,数据来源异构(包括SAOS API、JuDDGES等多系统),格式与元数据标准不统一,需进行跨源映射与schema对齐;其次,数据质量参差不齐,清理阶段需移除12,213项内部重复记录、27,473篇空文本及153篇超短文(<100字符),对此需设计精确的文本质量过滤流程;此外,确保从不同司法系统(如普通法与行政法体系)抽取的判决在日期、案号、法条引用等字段上的完整性与一致性,也对自动化处理提出了严峻考验。
常用场景
经典使用场景
pl-court-decisions数据集汇聚了波兰各级法院超过283万份判决全文,涵盖普通法院、行政法院、最高法院、宪法法庭及国家上诉庭的裁决,是迄今为止规模最大、覆盖面最广的波兰司法裁判语料库。其最经典的使用场景在于法律自然语言处理领域的预训练与微调:研究者可借助其海量、多样化的判决文本,训练能够理解波兰法律术语、判例逻辑和法官推理过程的语言模型,为法律文本生成、判决结果预测及法律信息检索等下游任务奠定基础。
解决学术问题
该数据集解决了多语法律NLP研究中波兰语司法数据严重匮乏的学术痛点。此前LEXTREME与Multi_Legal_Pile等知名基准中波兰判例数据完全缺失,而JuDDGES等资源也遗漏了最高法院、宪法法庭等关键机构的裁决。pl-court-decisions填补了这一空白,使得关于波兰法律体系的判决分析、先例演化追踪、法官决策模式挖掘等研究成为可能,显著推进了大陆法系国家司法大数据的开源利用与跨语种法律推理能力的评估。
衍生相关工作
基于pl-court-decisions衍生的经典工作首推其引入论文中提出的Multi-Legal-Bench基准,该基准利用此数据集跨层级、跨年代的判决文本,系统评估了大型语言模型在多司法管辖区、多语言及多法系下的法律推理能力。此外,该数据集可与JuDDGES系列资源结合,构建更完整的波兰司法数据集家族,支撑从判决分类、法律摘要生成到法条引用预测等一系列标准化评测任务,成为大陆法系NLP研究的重要基石。
以上内容由遇见数据集搜集并总结生成


