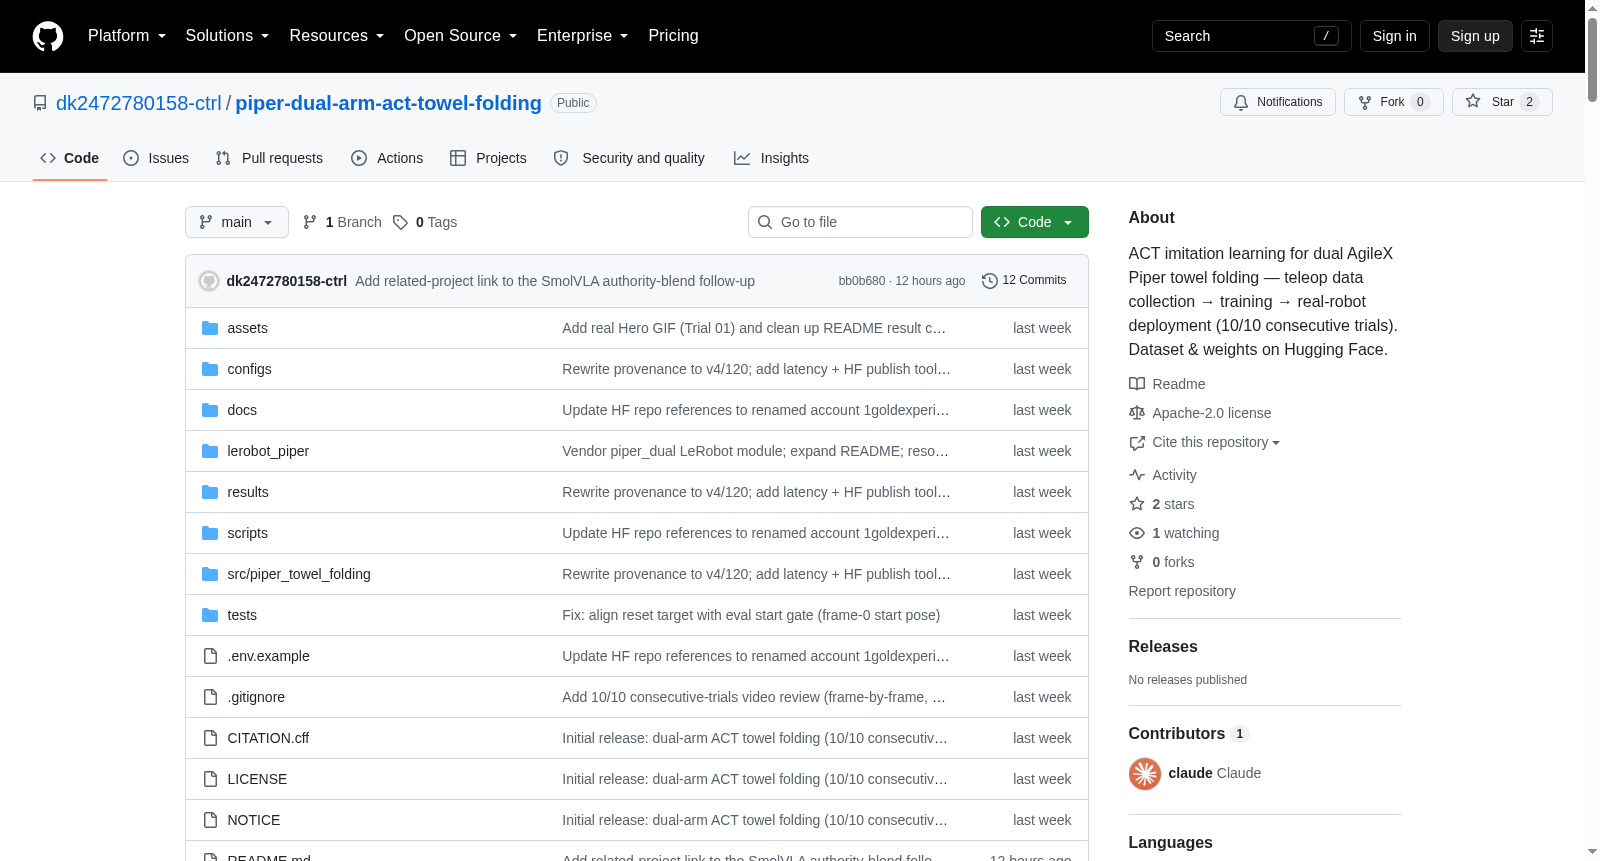
towel_fold_dataset_aug_v1
收藏资源简介:
120个真实双臂演示,包含85,187帧,帧率为30 FPS。
120 real dual-arm demonstrations, totaling 85,187 frames with a frame rate of 30 FPS.
项目概览
这是一个双机械臂衣物折叠(毛巾折叠)模仿学习项目,基于 ACT(Action Chunking Transformer) 架构,在真实的双 AgileX Piper 机械臂上实现柔性物体(毛巾)的双手协同折叠操作。项目实现了从数据采集、模型训练到真实机器人实时控制部署的完整闭环。
核心技术框架
- 模仿学习与ACT:采用 CVAE + Transformer 策略,预测完整的动作块(action chunks)
- 双手协同控制:单一模型输出一个 14 维动作向量,同时驱动两条机械臂及两个夹爪
- LeRobot 数据集:使用 LeRobot 格式进行遥操作数据采集与存储
- gRPC 异步推理部署:服务器端(CUDA)持有模型,客户端(CPU)以 30 Hz 频率驱动机械臂
- 实时控制与安全机制:每一步控制命令前均经无依赖的安全层验证,默认空跑模式,实际执行需显式确认
数据集信息
- 数据规模:120 个真实双机械臂演示数据,共 85,187 帧(30 FPS)
- 数据存储:LeRobot episodes 格式(parquet + mp4)
- 数据标识:
local/towel_fold_dataset_aug_v1 - 发布地址:https://huggingface.co/datasets/1goldexperience1/towel_fold_dataset_aug_v1
- 相机配置:三个 RGB 视角(左、中、右),分辨率 640×480,30 fps
- 训练数据未启用图像增强
模型与训练配置
| 参数 | 值 |
|---|---|
| 动作空间维度 | 14(左臂 6 关节 + 左夹爪 + 右臂 6 关节 + 右夹爪) |
| 状态空间维度 | 28(两条手臂 × 7 个电机 × 位置+力矩) |
| ACT chunk 大小 | 100 |
| 训练批次大小 | 8 |
| 训练步数 | 目标 60,000 步,从零开始训练 |
| 模型标识 | towel_fold_act_v4_scratch60k |
| checkpoint | 全局步 040000(= last),SHA256: e118230cb7be20e307a64598fced077f50c631651b243deb2cf0db8366a4c28c |
| Piper SDK | 0.6.2 |
评估结果
系统在一次连续录制中完成 10 次试验并全部成功(10/10 consecutive trials)。
| 项目 | 值 |
|---|---|
| 录制方式 | 一次连续拍摄,无内部剪辑 |
| 试验跨度 | 1.5 - 314.0 秒(约 34 秒/次) |
| 完成/成功次数 | 10 / 10 |
| 人工重置 | 是(每次试验前操作员重新摆放毛巾) |
| 计时精度 | ±0.5 秒 |
| 评估用 checkpoint | v4 · 040000(= last) |
| 各阶段结果 | 接近、左右抓取、抬起、折叠、释放——每次试验中全部可见且成功 |
评估详情见:results/consecutive_10_trials.csv 与 results/consecutive_10_trials_review.md。
系统架构与数据流
遥操作采集 → LeRobot 数据集 → ACT 训练 → checkpoint → gRPC policy_server (CUDA) → robot_client (CPU) → 2 × Piper (CAN) → 30 Hz 观测反馈 → 下一个动作块
安全层在每个控制步骤均执行:起始姿态校验(0.15 rad / 0.02 m)、每指令步长限制(0.10 rad / 0.01 m)、跟踪误差(0.35 rad / 0.03 m)、硬件关节限位、夹爪裁剪至 [0, 0.08] m,且从不发送禁用命令(机械臂保持 ENABLED 以防坠落)。
硬件环境
| 组件 | 规格 |
|---|---|
| 机械臂 | 2 × AgileX Piper(6-DoF + 夹爪),左臂接 can1,右臂接 can0 |
| 相机 | 3 × 640×480 @ 30 fps,udev 符号链接 /dev/camera_{left,middle,right} |
| 主机 | Ubuntu + NVIDIA A10(24 GB)用于训练与 CUDA 推理 |
| 驱动 / CUDA | 595.84 / 13.2 |
模型权重与视频说明
- Model Weights:
pretrained_model/(v4 040000 = last),发布地址:https://huggingface.co/1goldexperience1/towel_fold_act_v4_040000 - 视频资料:仓库仅包含 GIF/封面/链接,原始录像保存在本地
- 权重与数据集不出现在 Git 仓库中,需通过导出安装指令获取(
docs/reproducibility.md)
相关项目
同一平台基于此 ACT 基线构建的 SmolVLA(视觉-语言-动作模型)进阶项目:保留本项目的 ACT checkpoint(towel_fold_act_v4_040000)作为安全保障基础(始终拥有夹爪控制权),通过连续权威混合添加 SmolVLA 塑形策略,详见:piper-dual-arm-smolvla-towel-folding。
许可与致谢
- LeRobot / ACTPolicy:Apache 2.0,基于 Tony Z. Zhao 的 ALOHA 工作
- AgileX Piper SDK:按其自身许可条款
- 本仓库以 Apache 2.0 许可发布