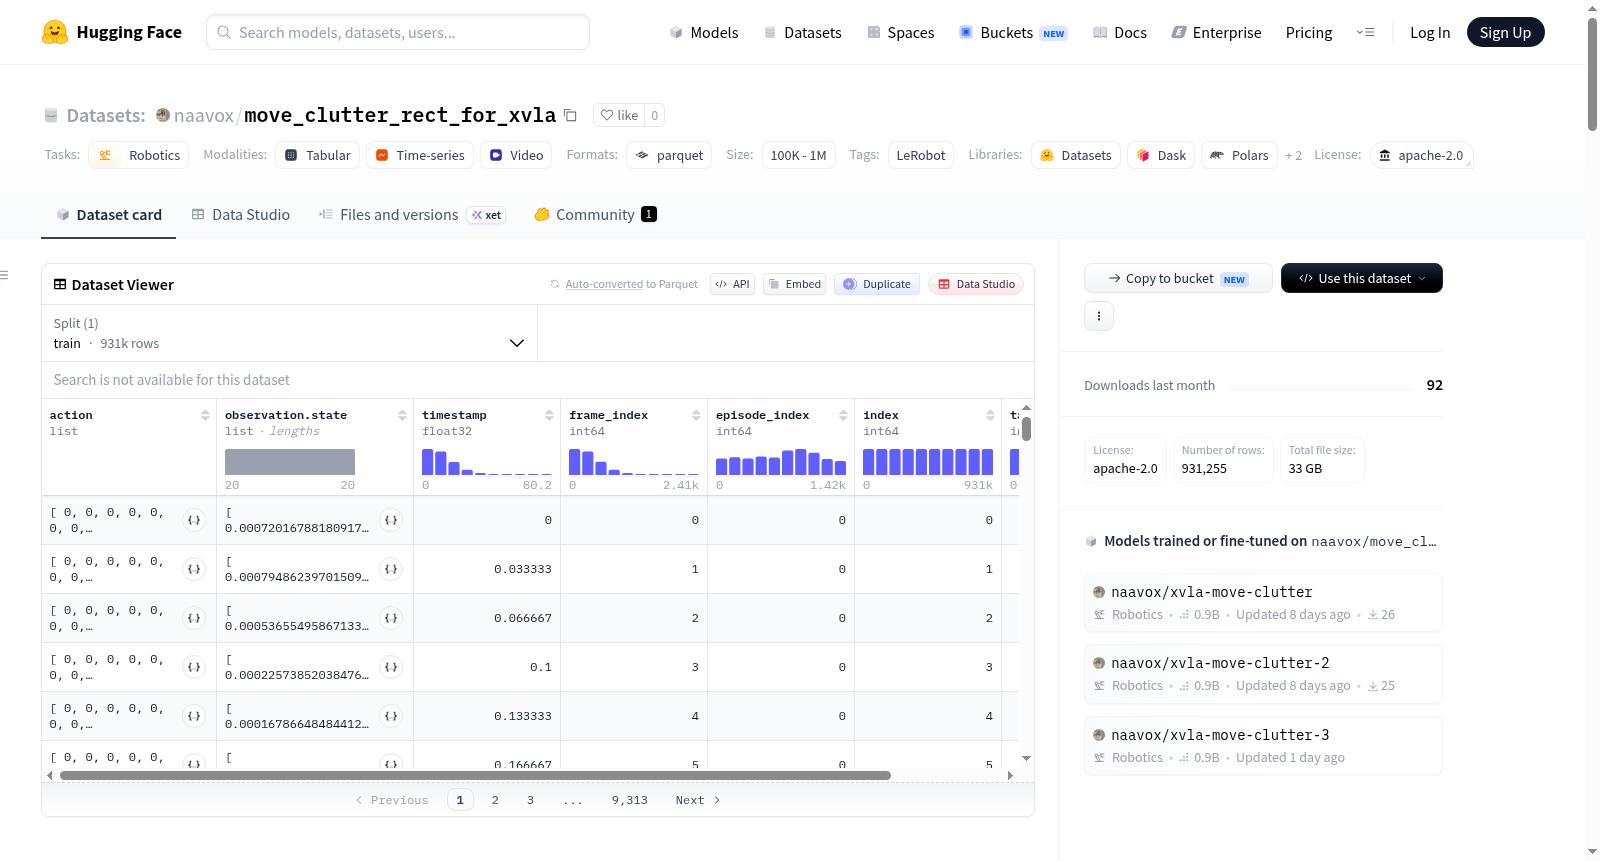
move_clutter_rect_for_xvla
收藏资源简介:
该数据集是一个用于机器人操作任务的数据集,由LeRobot框架创建。数据集包含1417个episode,共931255帧,涉及5个不同的任务。机器人类型为stringman。数据特征包括:动作(11维,包含线速度、角速度、腕部速度、手指速度、接触向量及episode结束标志)、状态(20维,包含速度、位置、角度、激光测距、压力、目标力、物体方位和距离等)、以及来自三个摄像头(gripper_camera、anchor_camera_0、anchor_camera_1)的彩色视频图像(分辨率384x684,30fps)。此外,还包含时间戳、帧索引、episode索引、任务索引等元数据。数据集适用于机器人模仿学习、行为克隆、强化学习等任务,并支持通过LeRobot进行可视化。
This dataset is designed for robot manipulation tasks, created using the LeRobot framework. It contains 1417 episodes with a total of 931,255 frames, covering 5 different tasks. The robot type is stringman. Data features include: actions (11-dimensional, encompassing linear velocity, angular velocity, wrist velocity, finger velocity, contact vector, and episode end flag), states (20-dimensional, including velocity, position, angle, laser ranging, pressure, target force, object orientation and distance, etc.), and color video images from three cameras (gripper_camera, anchor_camera_0, anchor_camera_1) with resolution 384x684 at 30fps. Additionally, metadata such as timestamps, frame indices, episode indices, and task indices are included. The dataset is suitable for tasks like robot imitation learning, behavior cloning, and reinforcement learning, and supports visualization via LeRobot.
数据集概述:move_clutter_rect_for_xvla
基本信息
- 数据集名称: move_clutter_rect_for_xvla
- 创建工具: 使用 LeRobot 创建
- 许可证: Apache-2.0
- 任务类型: 机器人(Robotics)
- 机器人类型: stringman
数据集规模
- 总片段数(Episodes): 1417
- 总帧数(Frames): 931,255
- 总任务数(Tasks): 5
- 帧率(FPS): 30
- 数据文件大小: 约100 MB
- 视频文件大小: 约200 MB
- 数据集划分: 全部数据(1417个片段)用于训练(train)
数据特征
动作(Action)
- 维度: 11维
- 数据类型: float32
- 包含字段: 速度(x/y/z)、房间速度(x/y)、手腕速度、手指速度、接触向量(x/y/z)、片段结束标志
观测状态(Observation State)
- 维度: 20维
- 数据类型: float32
- 包含字段: 速度(x/y/z)、手腕速度、手指速度、夹爪位置(x/y/z)、旋转角度、手指角度、激光测距仪读数、手指压力、手腕角度、目标力、障碍物方位/距离、玩具箱方位/距离、垃圾桶方位/距离
观测图像(Observation Images)
包含三个摄像头视角,均为视频流,具体参数如下:
- 分辨率: 384×684像素
- 通道数: 3(RGB)
- 视频编码: AV1
- 像素格式: yuv420p
- 帧率: 30 FPS
- 摄像头视角:
- gripper_camera: 夹爪摄像头
- anchor_camera_0: 锚点摄像头0
- anchor_camera_1: 锚点摄像头1
其他特征
- 时间戳(timestamp): float32,1维
- 帧索引(frame_index): int64,1维
- 片段索引(episode_index): int64,1维
- 索引(index): int64,1维
- 任务索引(task_index): int64,1维
数据存储结构
- 数据文件路径:
data/chunk-{chunk_index:03d}/file-{file_index:03d}.parquet - 视频文件路径:
videos/{video_key}/chunk-{chunk_index:03d}/file-{file_index:03d}.mp4 - 分块大小: 1000
可视化
可通过 可视化工具 在线预览该数据集。